一个动作可以同时落在好几个分类里。对登录页做视觉走查,按目标是界面测试,按是否运行是静态测试,按方法偏黑盒,按阶段通常挂在系统测试,按执行方式可以是手工,也可以是截图比对工具。分类不是一棵树,是一组坐标轴,每根轴上各取一个值。
分类的目的不是背名词,是让不同层次、不同阶段的人知道自己在测什么、依据是什么、什么时候该换一种测法。
按目标:功能之外还有五个维度
界面测试(UI 测试)按 UI 设计稿和设计规则检查界面全部内容:显示是否完整、一致、准确、友好,屏幕大小变化时是否自适应、换行是否正常;布局、字体、图片是否符合需求;对话框、文本框、滚动条、选项按钮是否可用,有效和无效状态是否设计合理。
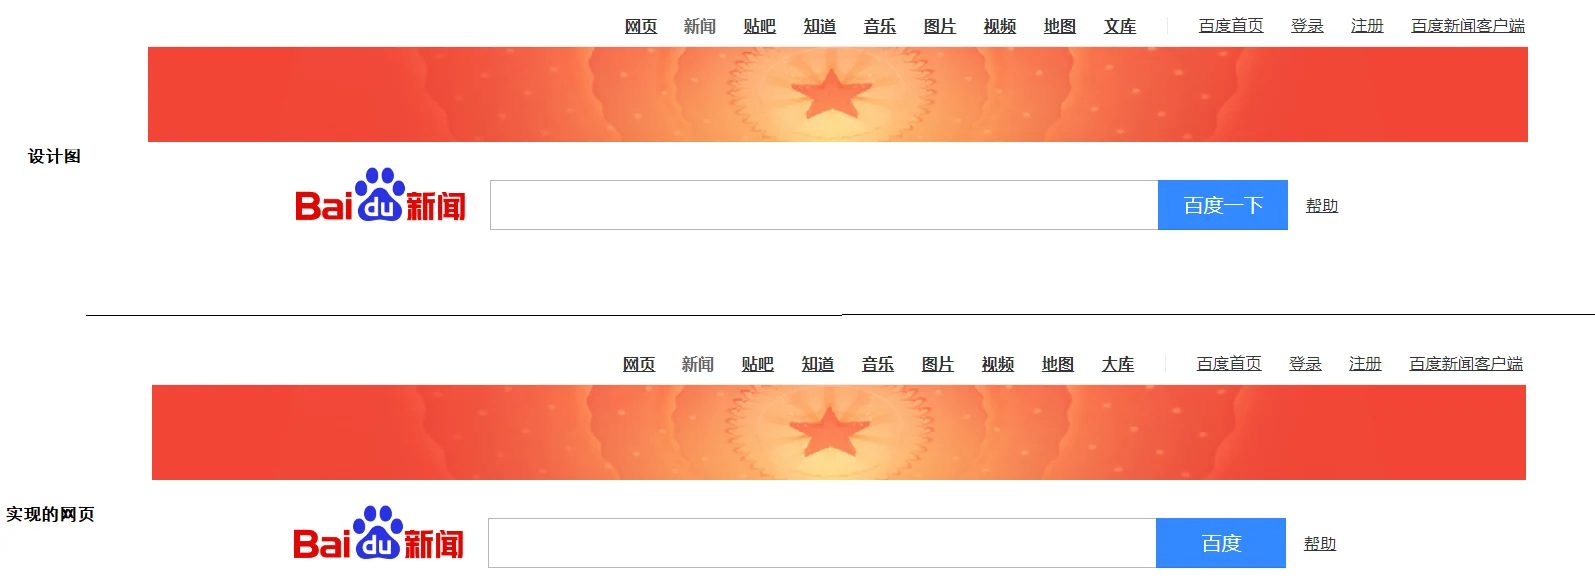
功能测试验证产品各功能是否达到用户要求:按功能用例逐项测,依据产品规格说明书,用黑盒方法设计用例——等价类、边界值、判定表、正交法、场景法、错误猜测。
性能测试针对页面打开越来越慢、查询很久才出列表这类问题,先分析性能需求,再基于需求和架构设计并执行测试,最后持续调优。
课件写「可靠性(Availability)即可用性」,把两个词当成了同义词。可靠性问「多久坏一次」,可用性问「需要的时候能不能用」,后者的公式是:
可用性 = 正常运行时间 /(正常运行时间 + 非正常运行时间)× 100%一个系统可以很可靠但不可用:一年坏一次,修三天。可用性常要求 99.99% 或 99.999%,对全年 7×24 运行的系统,全年是 365 × 24 × 60 = 525600 分钟,99.99% 对应约 52.6 分钟停机,99.999% 对应约 5.3 分钟。课件把分母写成 252600 分钟,少算 27 万,四个 9 的停机时间会缩水一半。
要求因系统而异:一般网站 99%、99.5% 就够,军事系统更高。
安全测试关注系统保护用户数据的隐私和完整、保护数据正常传输、抵御攻击的能力。常见漏洞:输入恶意脚本或超长字符串、SQL/XML 注入、不安全的数据存储或传递、配置文件里藏有害信息、访问控制或权限分配有问题、假冒身份、篡改数据。方法有代码评审、渗透测试、安全运维;静态工具常见 Coverity、AppScan Source、Fortify,动态工具常见 OWASP ZAP、WebInspect,静态安全测试最常用。
易用性测试看软件是否容易发现、容易学习、容易使用,包含七个要素:符合标准和规范、直观性、一致性、灵活性、舒适性、正确性、实用性。课件把这套定义挂到 ISO 25020 上,归属不对:25020 是质量测量方法标准;易用性在 ISO 9241-11 里的核心是有效性、效率和满意度。七个要素照用,标准名别跟着抄。
四项常检查。标准性:界面和对话框符合平台习惯,偏离应报缺陷。直观性:功能易懂、布局合理、响应在预期内,统计结果用图表。灵活性:选项满足不同习惯,但太多会增加复杂度,九宫格、全键盘、手写是三种输入。舒适性:界面友好、美观、操作顺畅。
跑没跑程序,是静态与动态的分界
静态测试不运行被测软件,只检查代码、界面或文档中的错误,常见方式是代码走查和扫描工具。动态测试要运行程序,输入测试数据,比对实际输出和预期结果。
判断一个测试属于静态还是动态,唯一标准就是看程序有没有跑起来。这一条能拆掉很多混淆:CI 里的 SonarQube 全自动,但它分析源码,属于静态测试;用脚本把设计稿和截图做像素比对,全自动但程序没启动,仍是静态;手工点登录是动态;框架用例真的调用了被测函数,也是动态。
多数测试工作属于动态测试。
白盒:看不看代码,决定用例从哪来
白盒测试又叫结构测试,分析程序内部结构,针对逻辑结构设计用例;目的是覆盖逻辑路径,在程序不同位置设检查点,确认实际状态与预期一致。
课件把白盒方法分成两条分支:静态手段有桌面检查、代码审查、代码走查、代码扫描工具;动态手段是逻辑覆盖法和基本路径测试法。
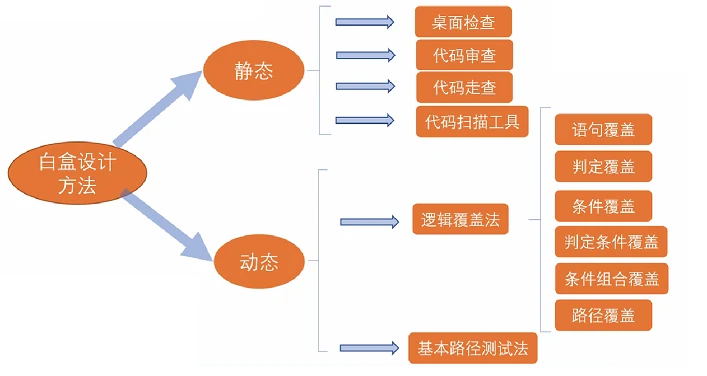
逻辑覆盖有六种。用下面这段代码做例子:
int score(int a, int b, int c, int d)
{
    int r = 0;

    if (a && b)
    {
        r += 10;
    }
    if (c || d)
    {
        r += 5;
    }

    return r;
}先分清两个词:条件是不能再拆的原子判断(a、b、c、d);判定是由条件组合成、整体能取真假的表达式(a && b、c || d)。
| 覆盖 | 要求 | 最少用例 |
|---|---|---|
| 语句覆盖 | 每条可执行语句至少执行一次 | 1 |
| 判定覆盖 | 每个判定的真假分支各走一次 | 2 |
| 条件覆盖 | 每个原子条件真假各取一次 | 2(纸面) |
| 判定条件覆盖 | 判定覆盖与条件覆盖同时满足 | 2~3 |
| 条件组合覆盖 | 每个判定内所有条件组合出现一次 | 4 |
| 路径覆盖 | 每条可执行路径都走 | 随路径数增长 |
语句覆盖用 (1,1,1,0) 一条就够:两个 if 体、两个判定和 return 都执行了。它最弱,藏在不成立分支里的语句看不见。
判定覆盖要两个判定的真假都走到:(1,1,1,0) 和 (1,0,0,0)。
条件覆盖看每个原子条件,课件给的经典答案是 (T,T,T,T) 和 (F,F,F,F)。这段代码用了短路求值:a 为假时 b 不求值,c 为真时 d 不求值。第二组里 b、d 取的值其实没被程序看过。要在真实代码上做实条件覆盖,至少三条,并保证每个条件都被真正求值。
这里有个爱考的点:满足条件覆盖不一定满足判定覆盖。a 真 b 假、a 假 b 真,原子条件都取过真假,判定却可能只走了假分支。两者看问题的粒度不同,不是简单的强弱关系。
判定条件覆盖是两者的并集,把用例合并去重,纸面上两组够,按真实短路执行要补一组。
条件组合覆盖要求每个判定内所有条件组合出现一次:a、b 四种,c、d 四种,四行就能覆盖;条件越多,按 2 的 n 次方增长。落到短路代码上,c 为真时 d 不求值,这四行并不能真正执行 d 的全部组合,报覆盖率前要分清纸面覆盖和执行覆盖。
路径覆盖数的是四条,不是三条
课件给了一个具体例子:
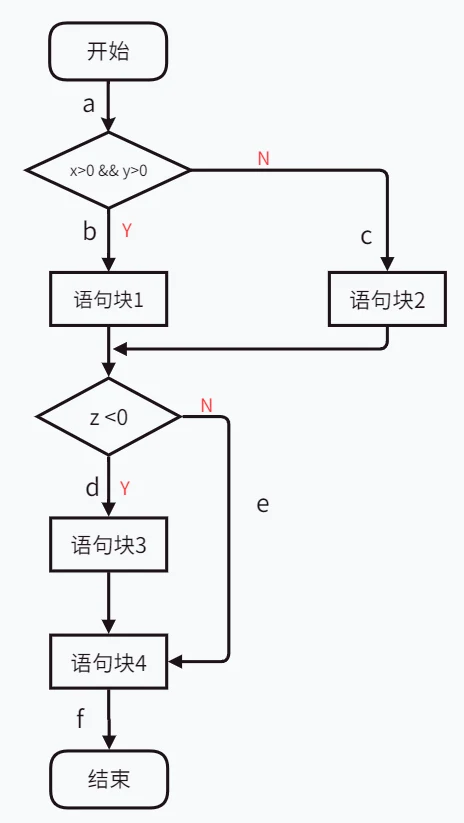
代码结构是:
if (x > 0 && y > 0)     /* 判定 P1,条件 C1、C2 */
{
    /* 语句块 1 */
}
else
{
    /* 语句块 2 */
}
if (z < 0)              /* 判定 P2,条件 C3 */
{
    /* 语句块 3 */
}
/* 语句块 4 */
有人会顺手写「P1 为假就跳过 P2」,于是只数出三条路径。看流程图就知道不对:P1 的假分支先进语句块 2,然后箭头向下汇合,照样到达 P2 判定框。所以是四条。
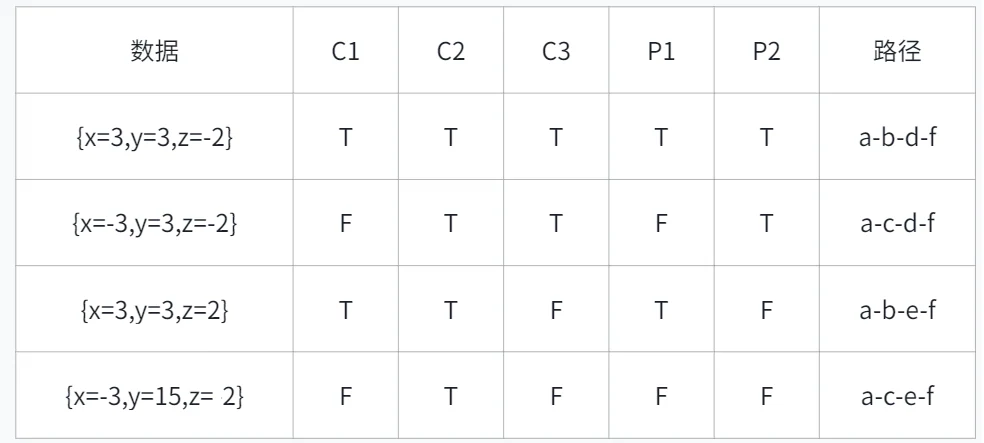
只写三条,路径 3 和 4 会被合并成一条「P1 假」,P2 为假那一支就漏了。再细一层,&& 是短路的,x 为 0 时 y 不被求值;按语句路径算四条,按条件路径算还要再拆。测试计划要写明路径按哪种口径数,否则两个人报出的覆盖率不可比。
课件的总结可以直接用:白盒主要用在单元测试阶段;先做静态设计,再做动态设计;设计用例一般用路径测试,重点模块追加逻辑覆盖。
黑盒测试完全不考虑程序逻辑和内部结构,只检查系统功能是否按需求规格正常使用、能否正确接收输入并输出结果,所以也叫数据驱动测试。优点是不需要了解代码,从用户角度设计用例,依据需求文档不容易漏功能;缺点是不可能覆盖所有代码。常用方法有等价类、边界值、因果图、场景法、错误猜测。
灰盒测试介于两者之间,多用于集成测试,既关注输入输出的正确性,也关注程序内部情况。它没有白盒详细完整,也覆盖不了黑盒的产品范围,基本不能替代黑盒。
面试问「知道哪些测试方法、哪种用得多」,可以答:开发人员主要用白盒和灰盒,测试人员主要用白盒和黑盒;对测试人员来说,黑盒用得更多。
四个阶段:单元、集成、系统、验收
| 阶段 | 测试对象 | 主要执行者 | 依据 | 方法 |
|---|---|---|---|---|
| 单元测试 | 最小模块 | 白盒测试工程师或开发 | 代码和注释、详细设计 | 白盒 |
| 集成测试 | 模块间接口 | 白盒测试工程师或开发 | 单元测试通过的模块、概要设计 | 黑盒与白盒结合 |
| 系统测试 | 整个系统(软硬件) | 黑盒测试工程师 | 需求规格说明 | 黑盒 |
| 验收测试 | 整个系统 | 最终用户或需求方 | 用户需求、验收标准 | 黑盒 |
单元测试与编码同步进行,针对软件最小组成单元。「最小」是人为定义的,一个方法、一个类都可以算。测试阶段可以在编码后,也可以在编码前(TDD);测试内容是模块接口、局部数据结构、路径、错误处理、边界。
课件用冒泡排序做例子,测了四组:无序数组、已经有序、空数组、含重复元素的数组,每组用 Arrays.equals 比对实际和预期。JUnit 把这套动作标准化:@Test 标记测试方法,assertArrayEquals 一类断言负责比较,失败时直接给出差异。
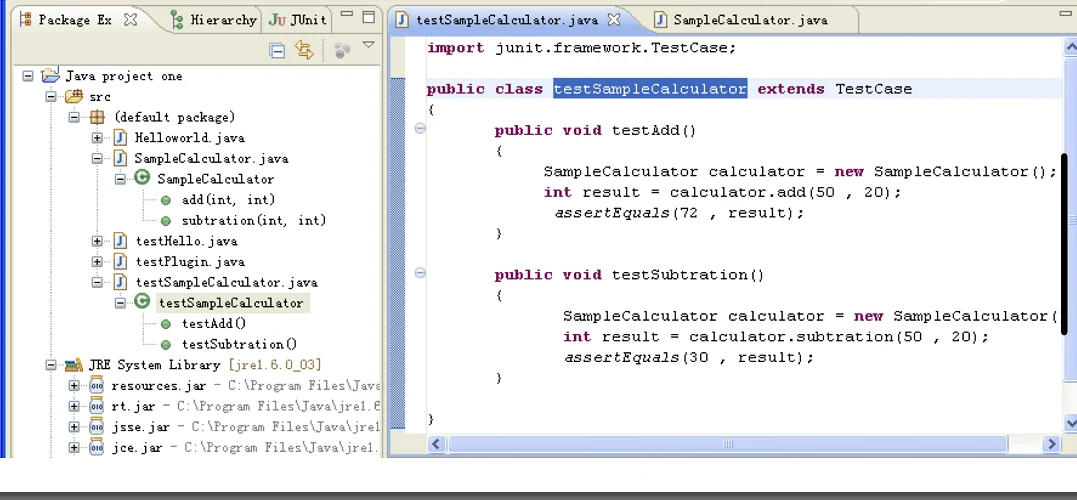
集成测试也叫联合测试、联调、组装测试,把模块按集成策略组装起来,重点检查模块之间的接口。测试内容是模块间数据传输、功能冲突、组装后的功能正确性、全局数据结构、单模块缺陷对系统的影响。集成阶段最典型的翻车是单元全绿、一拼就崩:A 传 yyyy-MM-dd,B 期待 yyyy/MM/dd;A 改了错误码语义,B 还按旧的判断。
系统测试对通过集成的系统做整体验证,依据需求规格,检查功能、界面、可靠性、易用性、性能、兼容性、安全等。
冒烟测试源自硬件行业:给设备加电,没冒烟就算通过。软件里,它针对每一个新编译、需要正式测试的版本,在系统测试之前执行,确认主要功能和核心流程正常。提测后先冒烟,通过就进入正式系统测试,不通过就打回开发重修,直到冒烟通过。
回归测试是修改旧代码后重新测试,确认修改没有引入新错误、没有让其他代码出错。它在整个测试过程中占很大工作量,各阶段都会反复做;系统越庞大,回归成本越高,所以要用回归策略控制范围。回归主要由人工和自动化完成,重复且一致的回归最适合交给自动化。
探索性测试边设计边执行,靠经验和直觉找问题,适合需求不稳定或时间紧的场景。
验收测试针对用户需求,对通过系统测试的软件做交付性测试,由用户或其他授权机构决定是否接受,是部署前的最后一个测试操作,也叫交付测试。依据是项目合同、任务书、双方约定的验收文档。
课件用造车做比:买来的车轮、发动机要检验,对应单元测试;零部件组装成整车并初步检查,对应集成测试;车企专业测试人员做完整检测,对应系统测试;车展或 4S 店里用户看外观、试性能,对应验收测试。冒烟和回归不属于这四个阶段,是按目的分的动作,可以挂在任何阶段上。
手工与自动化,以及实施组织
手工测试由人逐条输入用例、观察结果,原始但必须。自动化测试是在预设条件下运行系统或应用并评估结果,预设条件包括正常和异常条件。按目标分,有功能测试自动化、性能测试自动化、安全测试自动化;按对象分,常见接口自动化和 UI 自动化。接口测试的 ROI 比 UI 测试高,因为它不依赖浏览器渲染,跑得快,失败时定位更直接。
| 自动化测试 | 手工测试 | |
|---|---|---|
| 优点 | 长期重复执行成本低、效率高、结果一致 | 对人员技术要求较低,能做发散性测试 |
| 缺点 | 初始投入和维护成本高,不能发散 | 效率低,人力和时间成本高 |
课件把自动化的优点写成「节省成本」,这句要补一个字:它省的是重复执行的长期成本,不是总成本。脚本开发、维护、环境搭建都要先投进去,项目周期短的时候,自动化可能比手工更贵。
按实施组织,大型通用软件正式发布前常做 α 和 β 测试。α 测试是内测,由公司内部用户在模拟实际操作环境下进行,目的是评价产品的 FLURPS(功能、可使用性、可靠性、性能和支持),不能由程序员或测试员完成。β 测试是公测,由最终用户在一个或多个场所使用,常通过邀请码召集用户。
两者的差别集中在:α 在公司内部、环境受开发方控制、用户少、时间集中、持续时间短;β 在用户环境、环境不受控、用户多、时间分散、持续时间长。通常 α 通过后再做 β。第三方测试由独立公司或组织执行,结论更中立,也常被用作商务或法律依据。
在哪测:国际化与本地化
国际化测试(i18n)检查软件在不同语言和地区能否正常工作,重点关注布局、时间、日期、数字格式、货币、机器型号。最典型的问题是文字膨胀:同一句话德语可能比英语长三分之一,按钮被撑破、文字被截断。
课件把它的对立面叫「本地测试」,并说前面讲的都属于本地测试。严格说,与国际化对应的是本地化测试(l10n),针对某个具体地区做语言、格式、法规适配;而「本地测试」通常指在本机或局域网环境里跑测试,不是同一个概念。
把八根轴走完,再回看开头那个视觉走查:它同时在目标、静态动态、方法、阶段、执行方式五根轴上取值。分类的价值就在这儿——每根轴都问一遍,理解里的空洞会自己露出来。
还没有评论 — 第一条由你来留。