把回归的账算一遍。30 个核心场景一轮 15 分钟,一周三次、一年 52 周,就是 39 小时,还不算走神和环境切换;写成脚本一轮 3 分钟,一年不到 8 小时。这个差额是自动化站得住脚的地方。
自动化的字面意思是用程序代替人的操作。生活里自动洒水机、自动洗手液、超市闸门都是这个思路。课件把它定义成在预设条件下运行系统或应用、评估运行结果,预设条件包括正常和异常两种情况。软件里的自动化测试把以人为驱动的测试行为转成机器执行,减少重复劳动,也把「怎么算通过」固定下来。
回归是主战场,但不是唯一战场
课件说自动化主要用来做回归测试。回归确实是主战场:多版本、改新功能怕影响旧功能,量大、逻辑固定、结果明确,最适合机器。但它不只做回归:冒烟、数据准备、环境检查、接口批量校验、性能压测都能用程序。把它理解成只能做回归,会漏掉省力的地方。
两道面试题的答案,很多人记反了
自动化能取代人工测试吗?不能。脚本是人写的,页面一改选择器就废,业务一变断言就错,它不会发现「这里少了一个需求」。探索性测试、易用性判断、新功能首轮验证仍要人。
自动化能大幅降低工作量吗?错误。它把重复执行的成本换成了开发维护成本,前期更累;准确说法是在一定程度上降低长期回归成本。看到「完全」「大幅」「彻底」,基本可以排除。
ROI 是净收益相对投入的比例。投入包括脚本开发、维护、环境和失败排查,收益来自执行次数和每次节省的时间;执行次数少、界面变化频繁,ROI 可能是负的。
接口和 UI:先分清自动化在测哪一层
自动化按对象分接口和 UI,UI 又分 Web、移动端。接口自动化直接发 HTTP 请求,校验状态码和字段,必要时查数据库;不开浏览器,跑得快,失败定位准。博客列表、登录、下单这类有明确输入输出的功能,大部分规则能在接口层验。
UI 自动化模拟界面操作。Web 的典型流程就是课件的百度搜索:打开浏览器、访问首页、输入关键词、点击「百度一下」、检查结果。移动端在模拟器或真机上操作 App,靠控件树定位。
课件说移动端「通常不是部署在真机上,而是装模拟器」。太绝对。模拟器便宜、能进 CI,适合批量回归;相机、传感器、厂商系统、真实性能,模拟器替代不了真机。常规做法是两者并用。移动端自动化稳定性差,一个重要原因是环境因素多。
接口 ROI 比 UI 高:不依赖渲染,几十毫秒对几秒;UI 还要维护选择器和等待,失败常混着真 bug、没等到、数据不对、环境差异。能在接口层验的规则,别放 UI 层。
金字塔和冰淇淋蛋筒:形状是被组织逼出来的
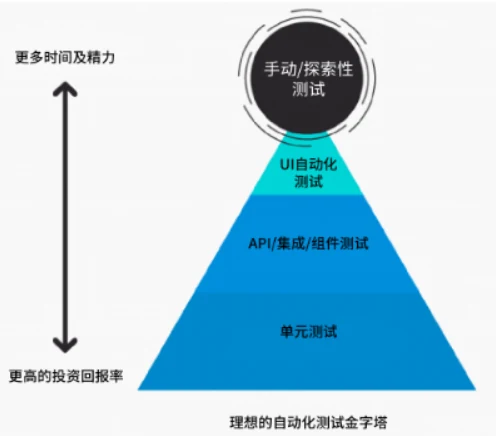
理想金字塔:单元最多,接口居中,UI 最少。越往上越慢、越依赖环境、失败越难定位、维护越贵。同样是金额算错,单元测试几毫秒告诉哪一行,UI 要跑完整下单流程才红。
现实常倒过来,叫冰淇淋蛋筒:大量 UI 堆顶部,单元薄得只剩锥尖。
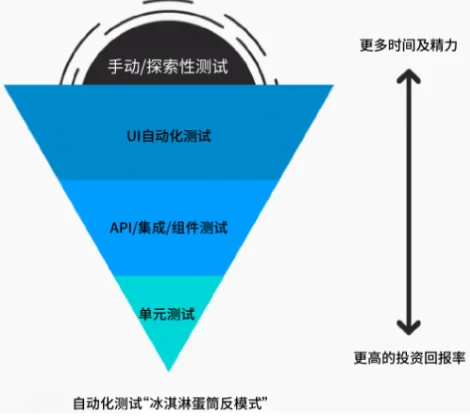
原因有技术也有组织:UI 看得见、好汇报,单元要读代码、做完没人看见;老项目没测试基础,补单元比页面点几下贵。
课件处理得务实:自动化要大量初始投资,先找到突破点,才看到长期成本收益;自动化和手工不对立,短期长期各有利弊。行动上至少别在倒金字塔上继续加 UI,新功能能在接口层验的别放 UI。
维护成本常被低估:页面改结构,十几条选择器失效;接口改字段名,一批断言全红。底层改动面小、修起来便宜,UI 用例数量本质上被维护预算卡住。
脚本到浏览器,中间隔着一条 HTTP 链路
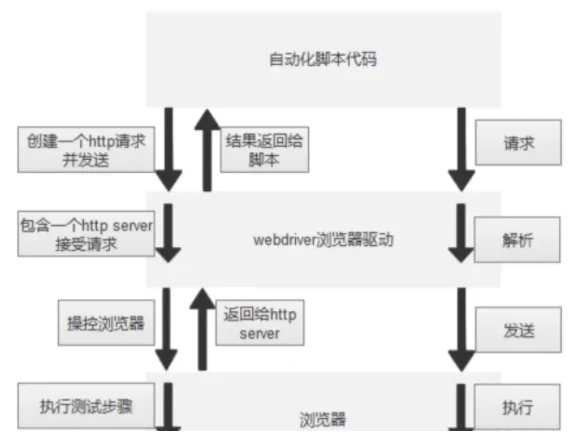
很多人以为 driver.get() 是 Python 直接调浏览器,实际是脚本、驱动、浏览器三段。
- 脚本创建 ChromeDriverService。
- 服务启动 WebDriver,监听本地端口。课件说「驱动服务 IP 为 localhost」,localhost 是主机名,驱动实际绑在
127.0.0.1上;容器里跑、脚本和浏览器不同机时,这个区别很要命。 - 脚本向驱动发 HTTP 请求,驱动打开浏览器并返回 session id,后续操作都带这个 id。
- 访问地址、查找元素等操作都通过服务发请求。
- 驱动把请求翻译成浏览器命令。
- 浏览器执行,结果经驱动返回。
课件还有一句「WebDriver 以本地化方式驱动浏览器」,原文是 natively,意思是原生、本地进程方式,不是本地化(l10n)。翻译错了,理解会偏。
链路也解释了一个现象:脚本崩了,浏览器窗口可能还留着。驱动和浏览器是两个进程,脚本退出不等于会话关闭,只有 quit() 会一起收掉。CI 里偶发浏览器进程泄漏,多半是异常路径没走到 quit()。
驱动管理:从 webdriver-manager 到 Selenium Manager
课件环境是 selenium 4.0.0 加 webdriver-manager,命令 pip install webdriver-manager、pip install selenium==4.0.0,支持 Python 3.7 到 3.11。手动装驱动每次浏览器更新都要跟着换,webdriver-manager 负责自动下载匹配版本。
今天这套已是历史。Selenium 4.6(2022 年 11 月)起内置 Selenium Manager,装好 selenium 后直接 webdriver.Chrome() 就能探测浏览器版本、下载并缓存驱动。
from selenium import webdriver
from selenium.webdriver.common.by import By

driver = webdriver.Chrome()
driver.get("https://www.baidu.com")

driver.find_element(By.CSS_SELECTOR, "#kw").send_keys("迪丽热巴")
driver.find_element(By.CSS_SELECTOR, "#su").click()

driver.quit()
这段对应课件五步:创建驱动、打开百度、输入关键词、点击搜索、关闭浏览器。旧版要写 webdriver.Chrome(service=ChromeService(ChromeDriverManager().install())),现在只在离线或锁版本时手动指定 Service(executable_path="/path/to/chromedriver")。
Chrome 115 之后 ChromeDriver 并入 Chrome,下载迁到 Chrome for Testing;旧版 webdriver-manager 的版本清单常失效,报 session not created 或卡下载。排查时先对齐浏览器、驱动、selenium 版本和系统位数。
选型和在 CI 里的位置
框架选型看四件事:团队语言栈、报告和断言够不够、能否并行和稳定重跑、维护成本。Selenium 驱动浏览器,pytest 组织用例、参数化和报告,是 Web 端常见搭配。
CI 里按成本分层:每次提交跑单元和接口,几分钟出结果;UI 回归放合并前或 nightly;冒烟放提测第一道,核心流程不过就打回。失败先分产品 bug、脚本问题、环境问题,否则「红了就重跑」会忽略真缺陷。
自动化解决重复执行和标准一致,解决不了该测什么和结果合不合理,这两件事仍要人判断。
还没有评论 — 第一条由你来留。