同一组数,插入排序、选择排序、归并排序都能排对,差别在代价、边界和相等元素的相对次序。排序算法要同时看四笔账:平均时间、最坏时间、额外空间、稳定性。比较类算法靠关键字比较来决定次序,计数排序跳出这个框架,直接按值记账。
排序算法的四类分法
排序(sorting)是把一串记录按某个或某些关键字的大小递增或递减排列。购物筛选、院校排名、订单金额排序都是它的应用。常见比较类算法按思想分成四类:
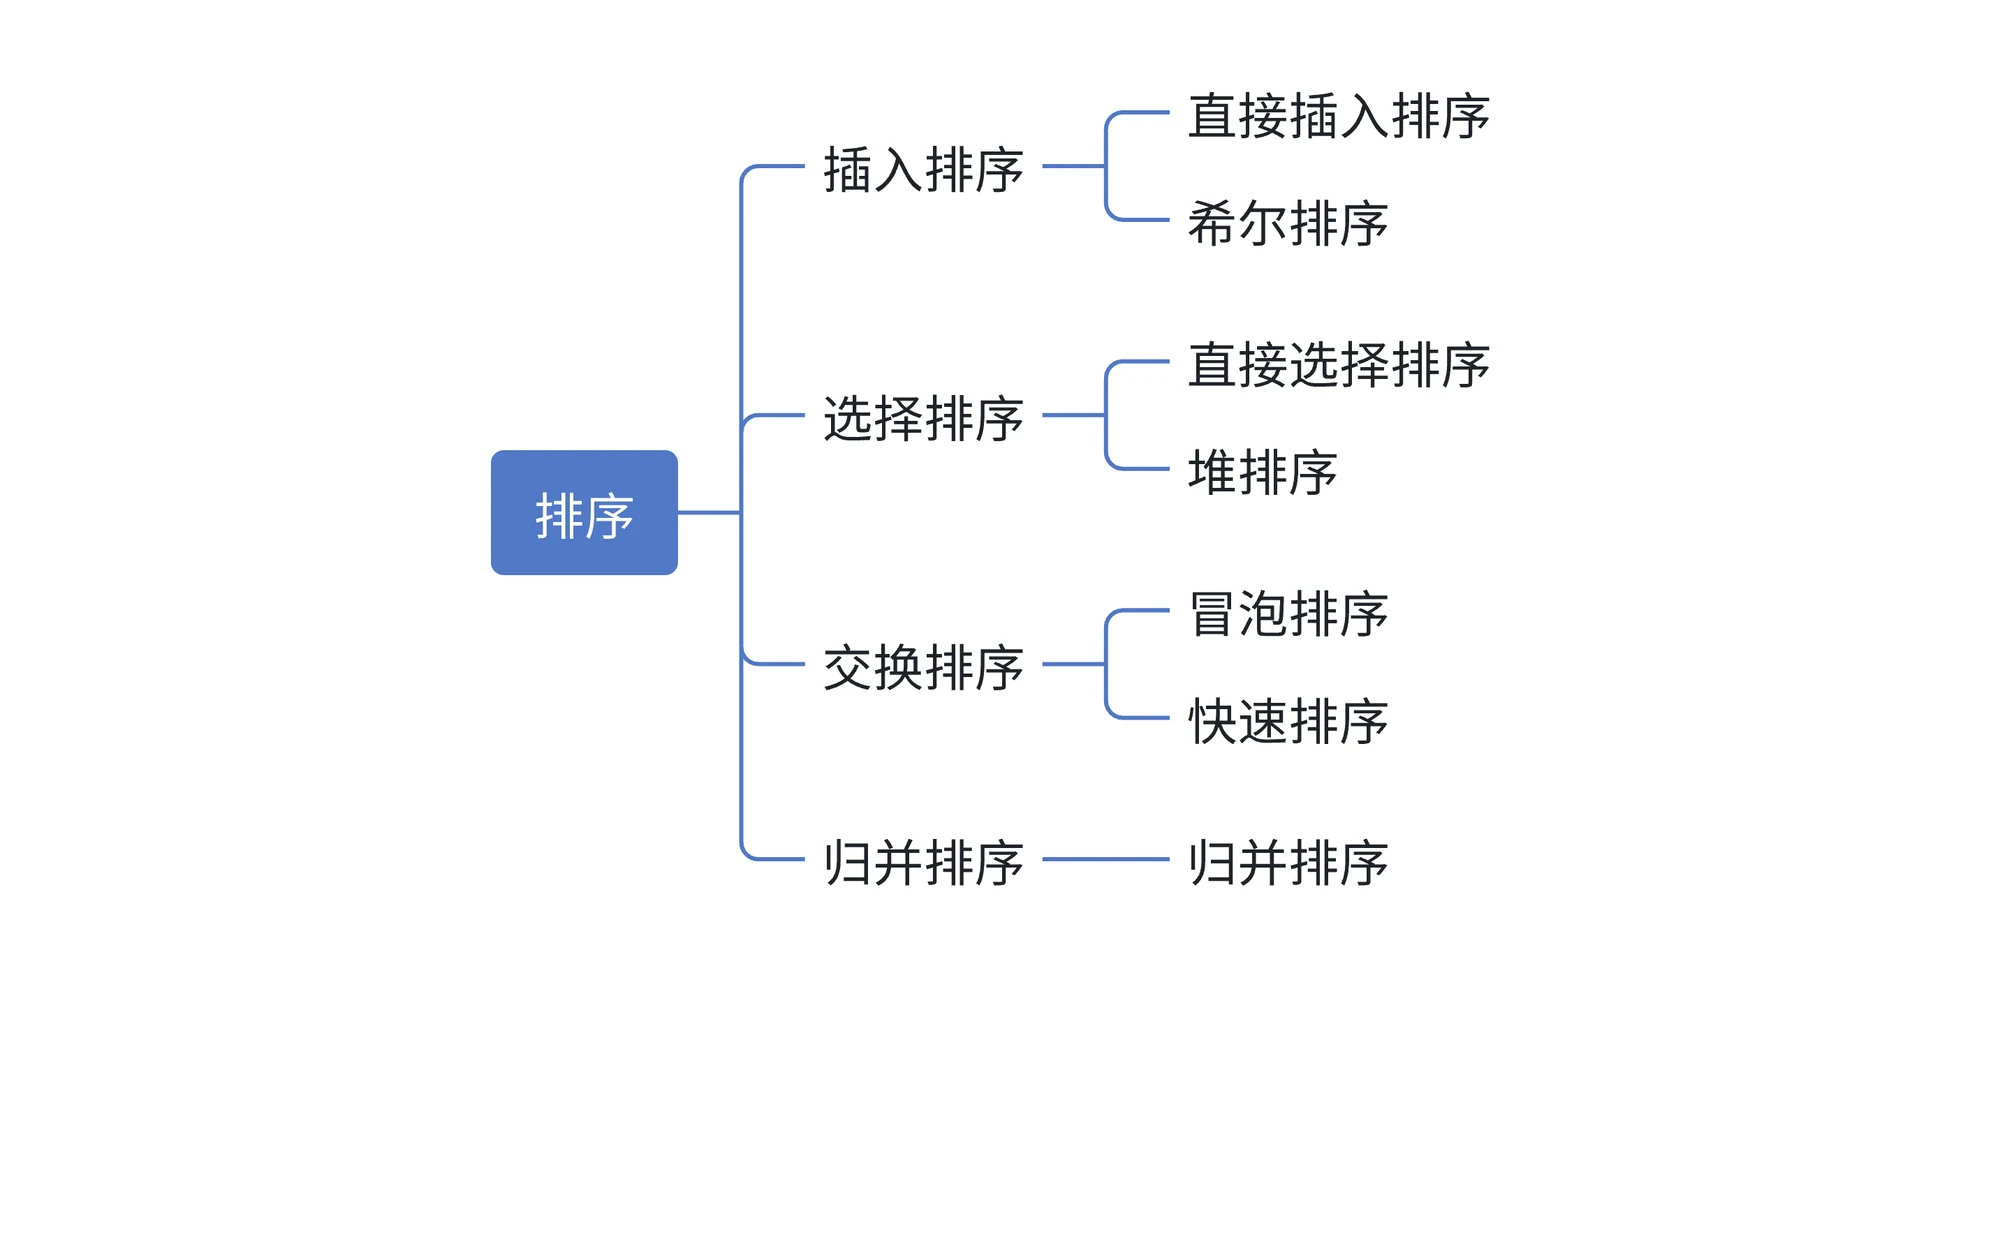
稳定性(stability)的定义是:待排序序列中有多个关键字相同的记录,排序后这些记录的相对次序保持不变,就说这个算法稳定;否则不稳定。稳定性不是排序函数的装饰属性,它取决于比较键和交换方式。同一个关键字不唯一时,输出本来就有多个合法答案;要不要保序,得先问清楚。
直接插入(insertion sort):有序前缀向右扩一格
直接插入排序维护一个不变式:[0, i] 这一段已经有序,把 a[i + 1] 插进去。
void InsertSort(int* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        int end = i;
        int tmp = a[end + 1];

        while (end >= 0 && a[end] > tmp)
        {
            a[end + 1] = a[end];
            --end;
        }
        a[end + 1] = tmp;
    }
}
while 里的 > 而不是 >=,保证相等元素不会越过彼此,这是插入排序稳定的原因。比较次数和移动次数随逆序对数量变化:已经有序时一次都不搬,完全逆序时搬 n(n-1)/2 次。所以“数据越接近有序,它越快”不是经验,是可以数出来的。最好 O(n),平均和最坏 O(n²),空间 O(1)。
希尔:用 gap 先消掉远处的逆序对
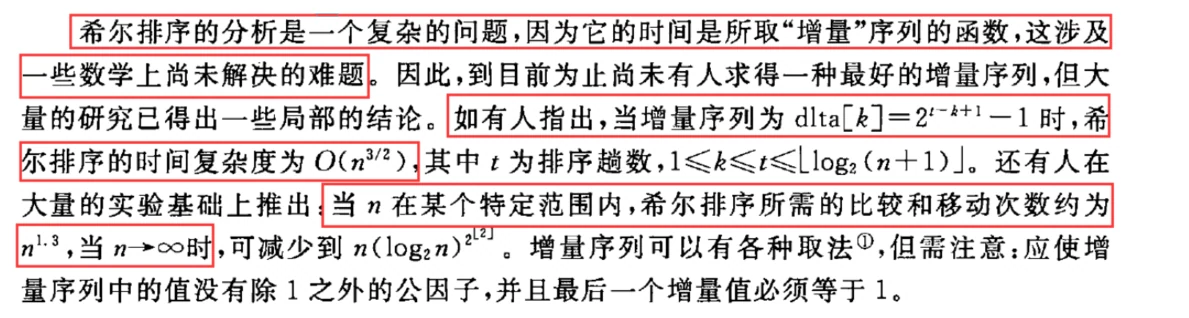
希尔排序(Shell sort)又叫缩小增量排序。它把相隔 gap 的元素分到同一组,对每组做插入排序;然后缩小 gap,最后 gap == 1 时退化成普通插入排序。
void ShellSort(int* a, int n)
{
    int gap = n;
    while (gap > 1)
    {
        gap = gap / 3 + 1;

        for (int i = 0; i < n - gap; ++i)
        {
            int end = i;
            int tmp = a[end + gap];
            while (end >= 0 && a[end] > tmp)
            {
                a[end + gap] = a[end];
                end -= gap;
            }
            a[end + gap] = tmp;
        }
    }
}
gap > 1 的每一轮都是预排序,目的不是让数组完全有序,而是让小元素一次跨过大段距离、把远处的逆序对成批消掉;收尾那轮 gap == 1,数组已经比较整齐,插入排序的代价很小。
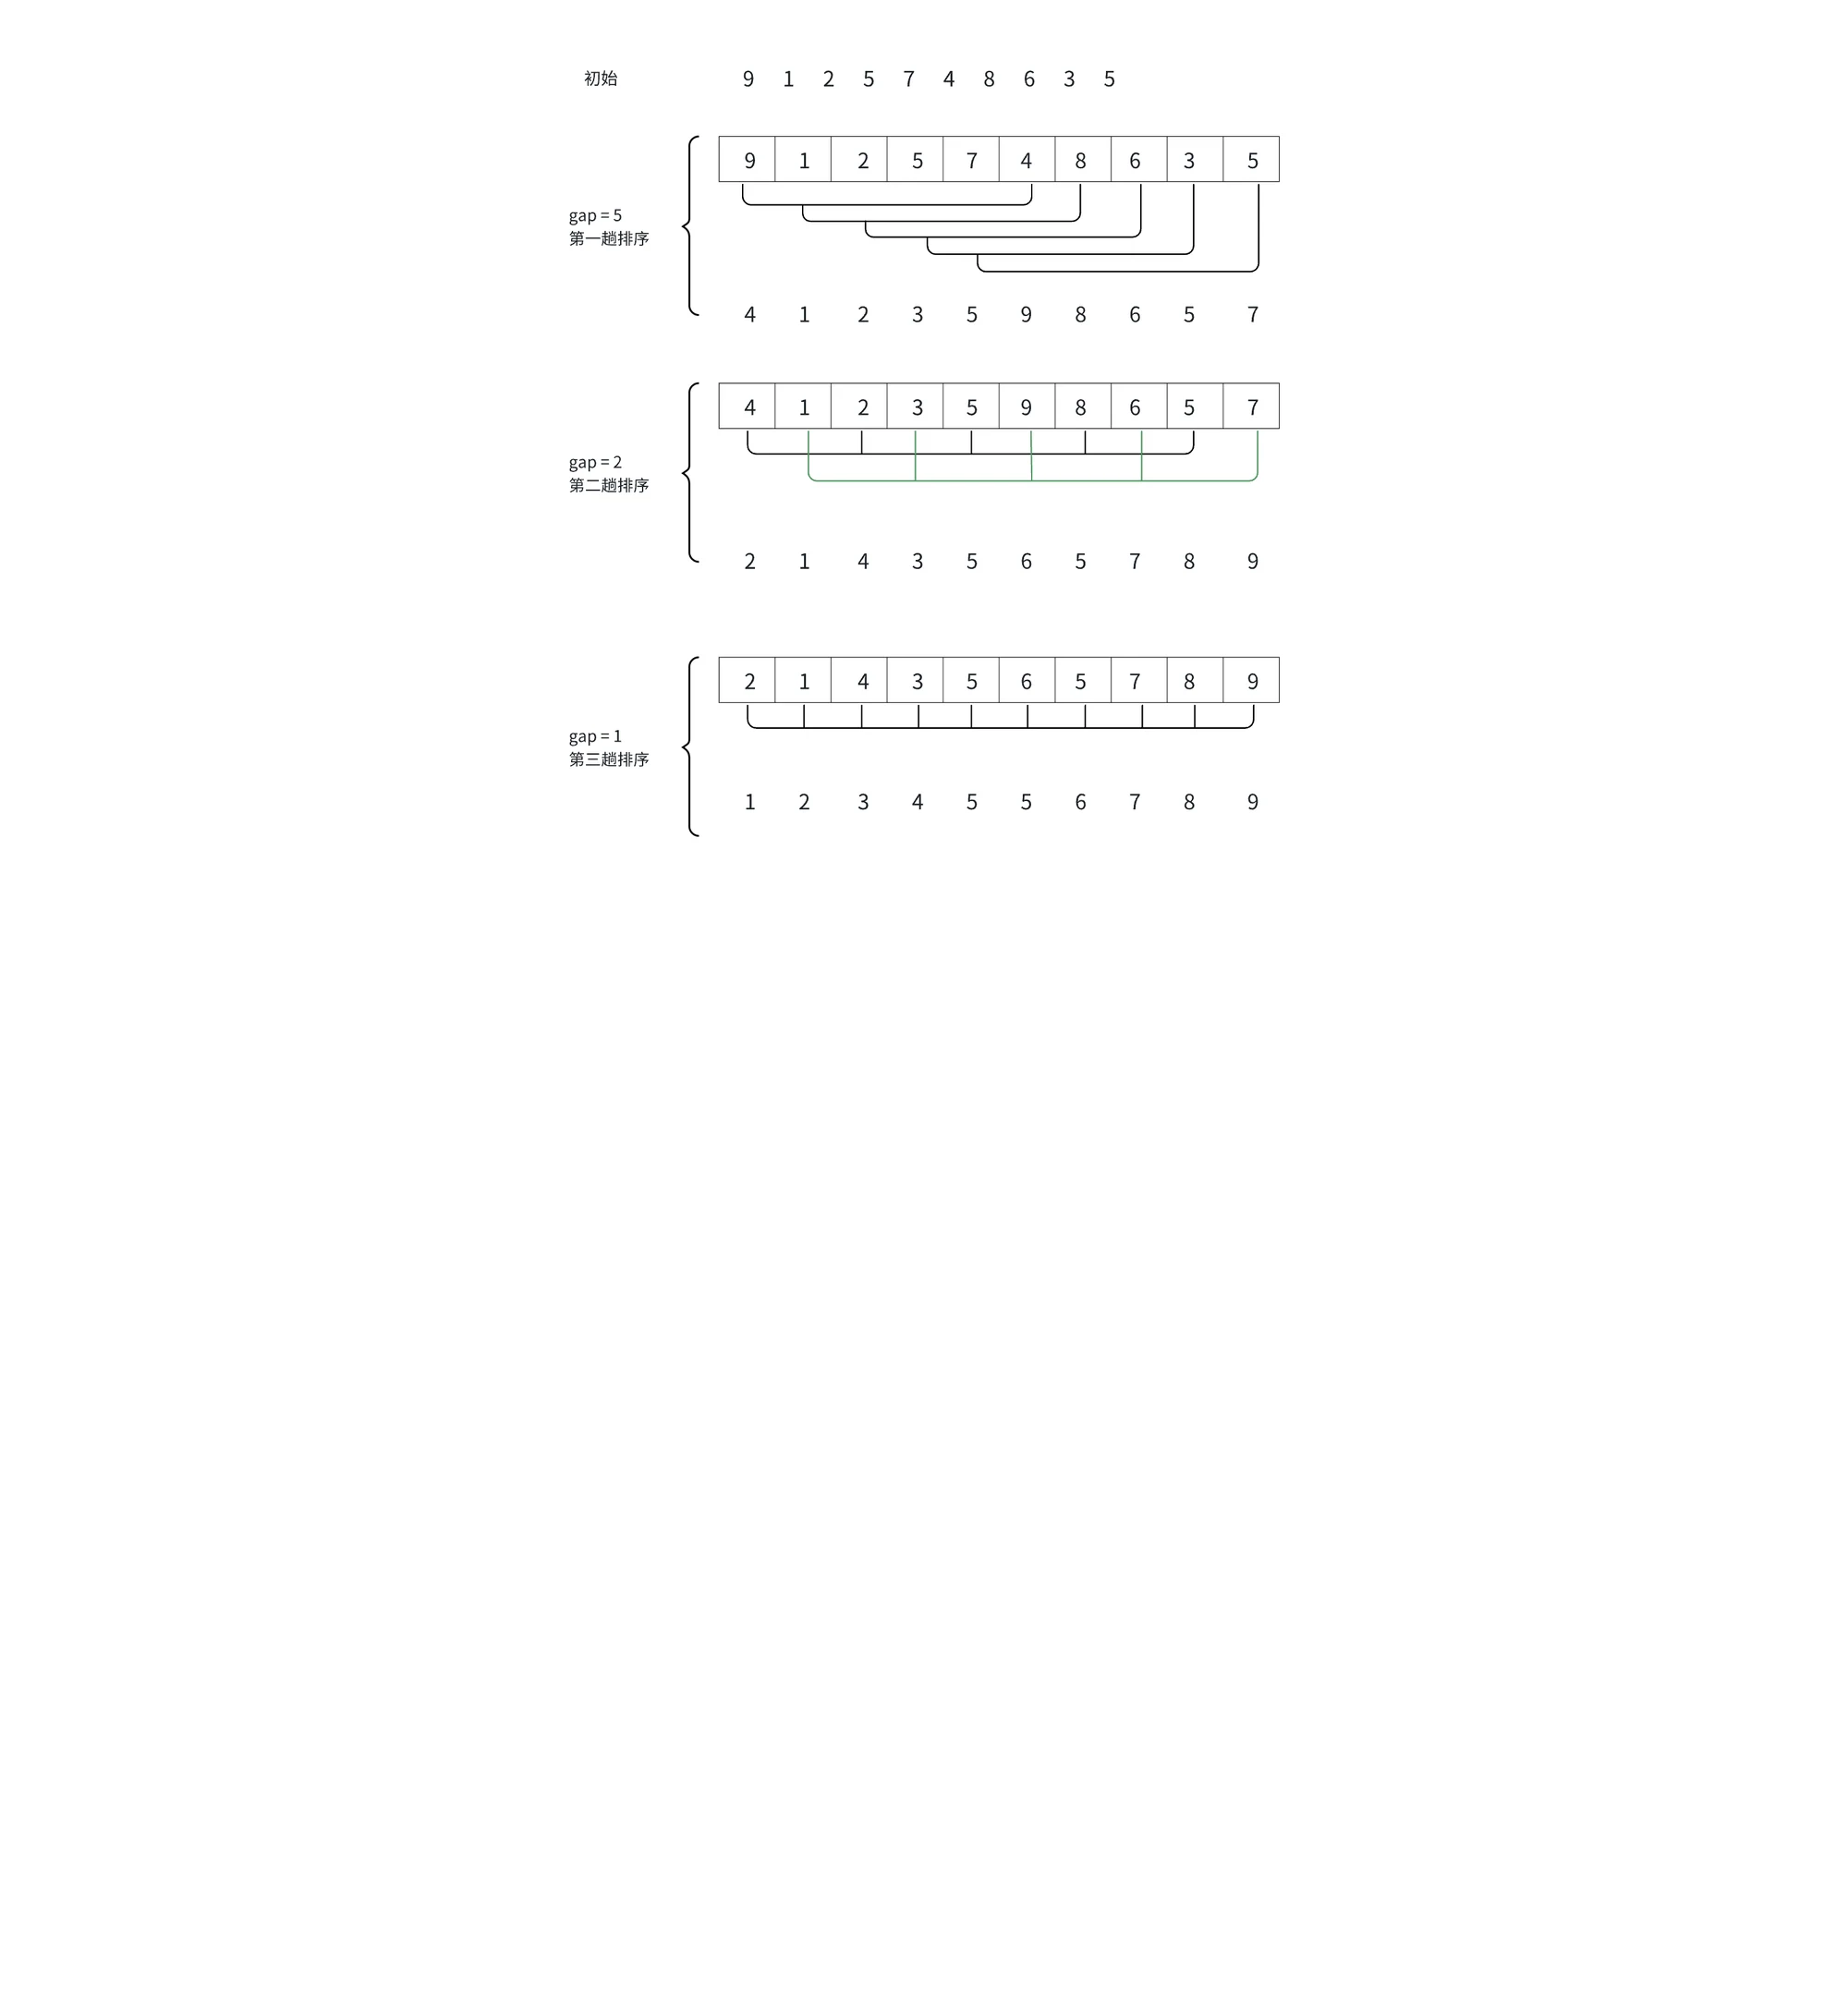
希尔排序的复杂度没有单一答案,取决于增量序列。课件引用的严蔚敏教材给了一个具体结论:增量序列取 2^(t-k+1) - 1 时,时间复杂度可证到 O(n^(3/2));实验数据在某个 n 范围内约为 n^1.3,n 趋于无穷时可减少到 n(log₂n)²。
通行说法是:平均约 O(n^1.3),最好 O(n log n),最坏 O(n²),辅助空间 O(1),不稳定。最好情况不是 O(n):即使输入已经有序,gap 递减仍要走完 log n 趟,每趟都要扫一遍数组。课件表格里希尔一行同时放了 ~O(nlog n)、O(n²)、O(n^1.3)、O(n²) 四个复杂度值,却只有平均、最好、最坏三列,列对齐出了问题;按增量序列不同取对应值,才是这张表想表达的意思。
课件说“希尔排序的效率肯定高于直接插入排序”,这个说法偏满。平均意义上它更快,但不保证每一个输入都更快:小数组、已经接近有序的数组,多趟预排序可能反而更贵。希尔排序不稳定,因为相等元素会被分到不同组,跨组移动时相对次序就乱了。反例是 5a 8 2 5b 9:gap = 2 时第一组 5a 2 9 排成 2 5a 9,第二组 8 5b 排成 5b 8,数组变成 2 5b 5a 8 9,5b 跑到了 5a 前面。
直接选择(selection sort):一趟同时定最小和最大
直接选择排序每一趟从待排序区间里选出最小和最大的元素,分别放到区间两端,然后缩小区间。
static void Swap(int* a, int* b)
{
    int t = *a;
    *a = *b;
    *b = t;
}

void SelectSort(int* a, int n)
{
    int begin = 0, end = n - 1;
    while (begin < end)
    {
        int mini = begin, maxi = begin;

        for (int i = begin; i <= end; ++i)
        {
            if (a[i] > a[maxi])
                maxi = i;
            if (a[i] < a[mini])
                mini = i;
        }

        if (begin == maxi)
            maxi = mini;      /* 第一次交换会把最大值挪到 mini 的位置 */

        Swap(&a[mini], &a[begin]);
        Swap(&a[maxi], &a[end]);
        ++begin;
        --end;
    }
}
if (begin == maxi) maxi = mini; 这一行救的是“最大值恰好站在 begin”的情况。第一次交换把最小值换到 begin,最大值被挤到 mini 的位置,但 maxi 还记着旧的 begin;不修正的话,第二次交换拿 a[maxi] 去和末尾换,换走的是最小值,最大值反而留在了开头。这个分支只在特定输入下出现,随机数据未必撞得上。
选择排序的时间复杂度在最好、平均、最坏都是 O(n²):不管数据什么样,每一趟都要把区间扫一遍。空间 O(1)。它不稳定,反例是 5a 8 5b 2 9:第一轮最小值 2 和第一个 5a 交换,5a 被扔到后面,跑到了 5b 的右边,结果是 2 8 5b 5a 9。
冒泡(bubble sort):exchange 必须每趟清零
void BubbleSort(int* a, int n)
{
    for (int i = 0; i < n; ++i)
    {
        int exchange = 0;               /* 每轮都要重新置零 */
        for (int j = 0; j < n - i - 1; ++j)
        {
            if (a[j] > a[j + 1])
            {
                Swap(&a[j], &a[j + 1]);
                exchange = 1;
            }
        }
        if (exchange == 0)
            break;                      /* 这一轮没换过,已经有序 */
    }
}
课件把 int exchange = 0; 写在了外层循环外面。后果不是“优化效果差一点”,而是优化彻底失效:只要第一轮发生过一次交换,exchange 就永远是 1,break 再也不会触发,后面的轮次照跑不误。只有“一开始就完全有序”的数组才能提前退出,那恰好是最不需要优化的情况。变量挪进循环体,它才有意义。
冒泡最好 O(n)(一轮扫完无交换),最坏与平均 O(n²),空间 O(1)。它稳定,因为只在严格大于时交换,相等元素不会被换到彼此后面。
快速排序(quicksort):三种划分与两个优化
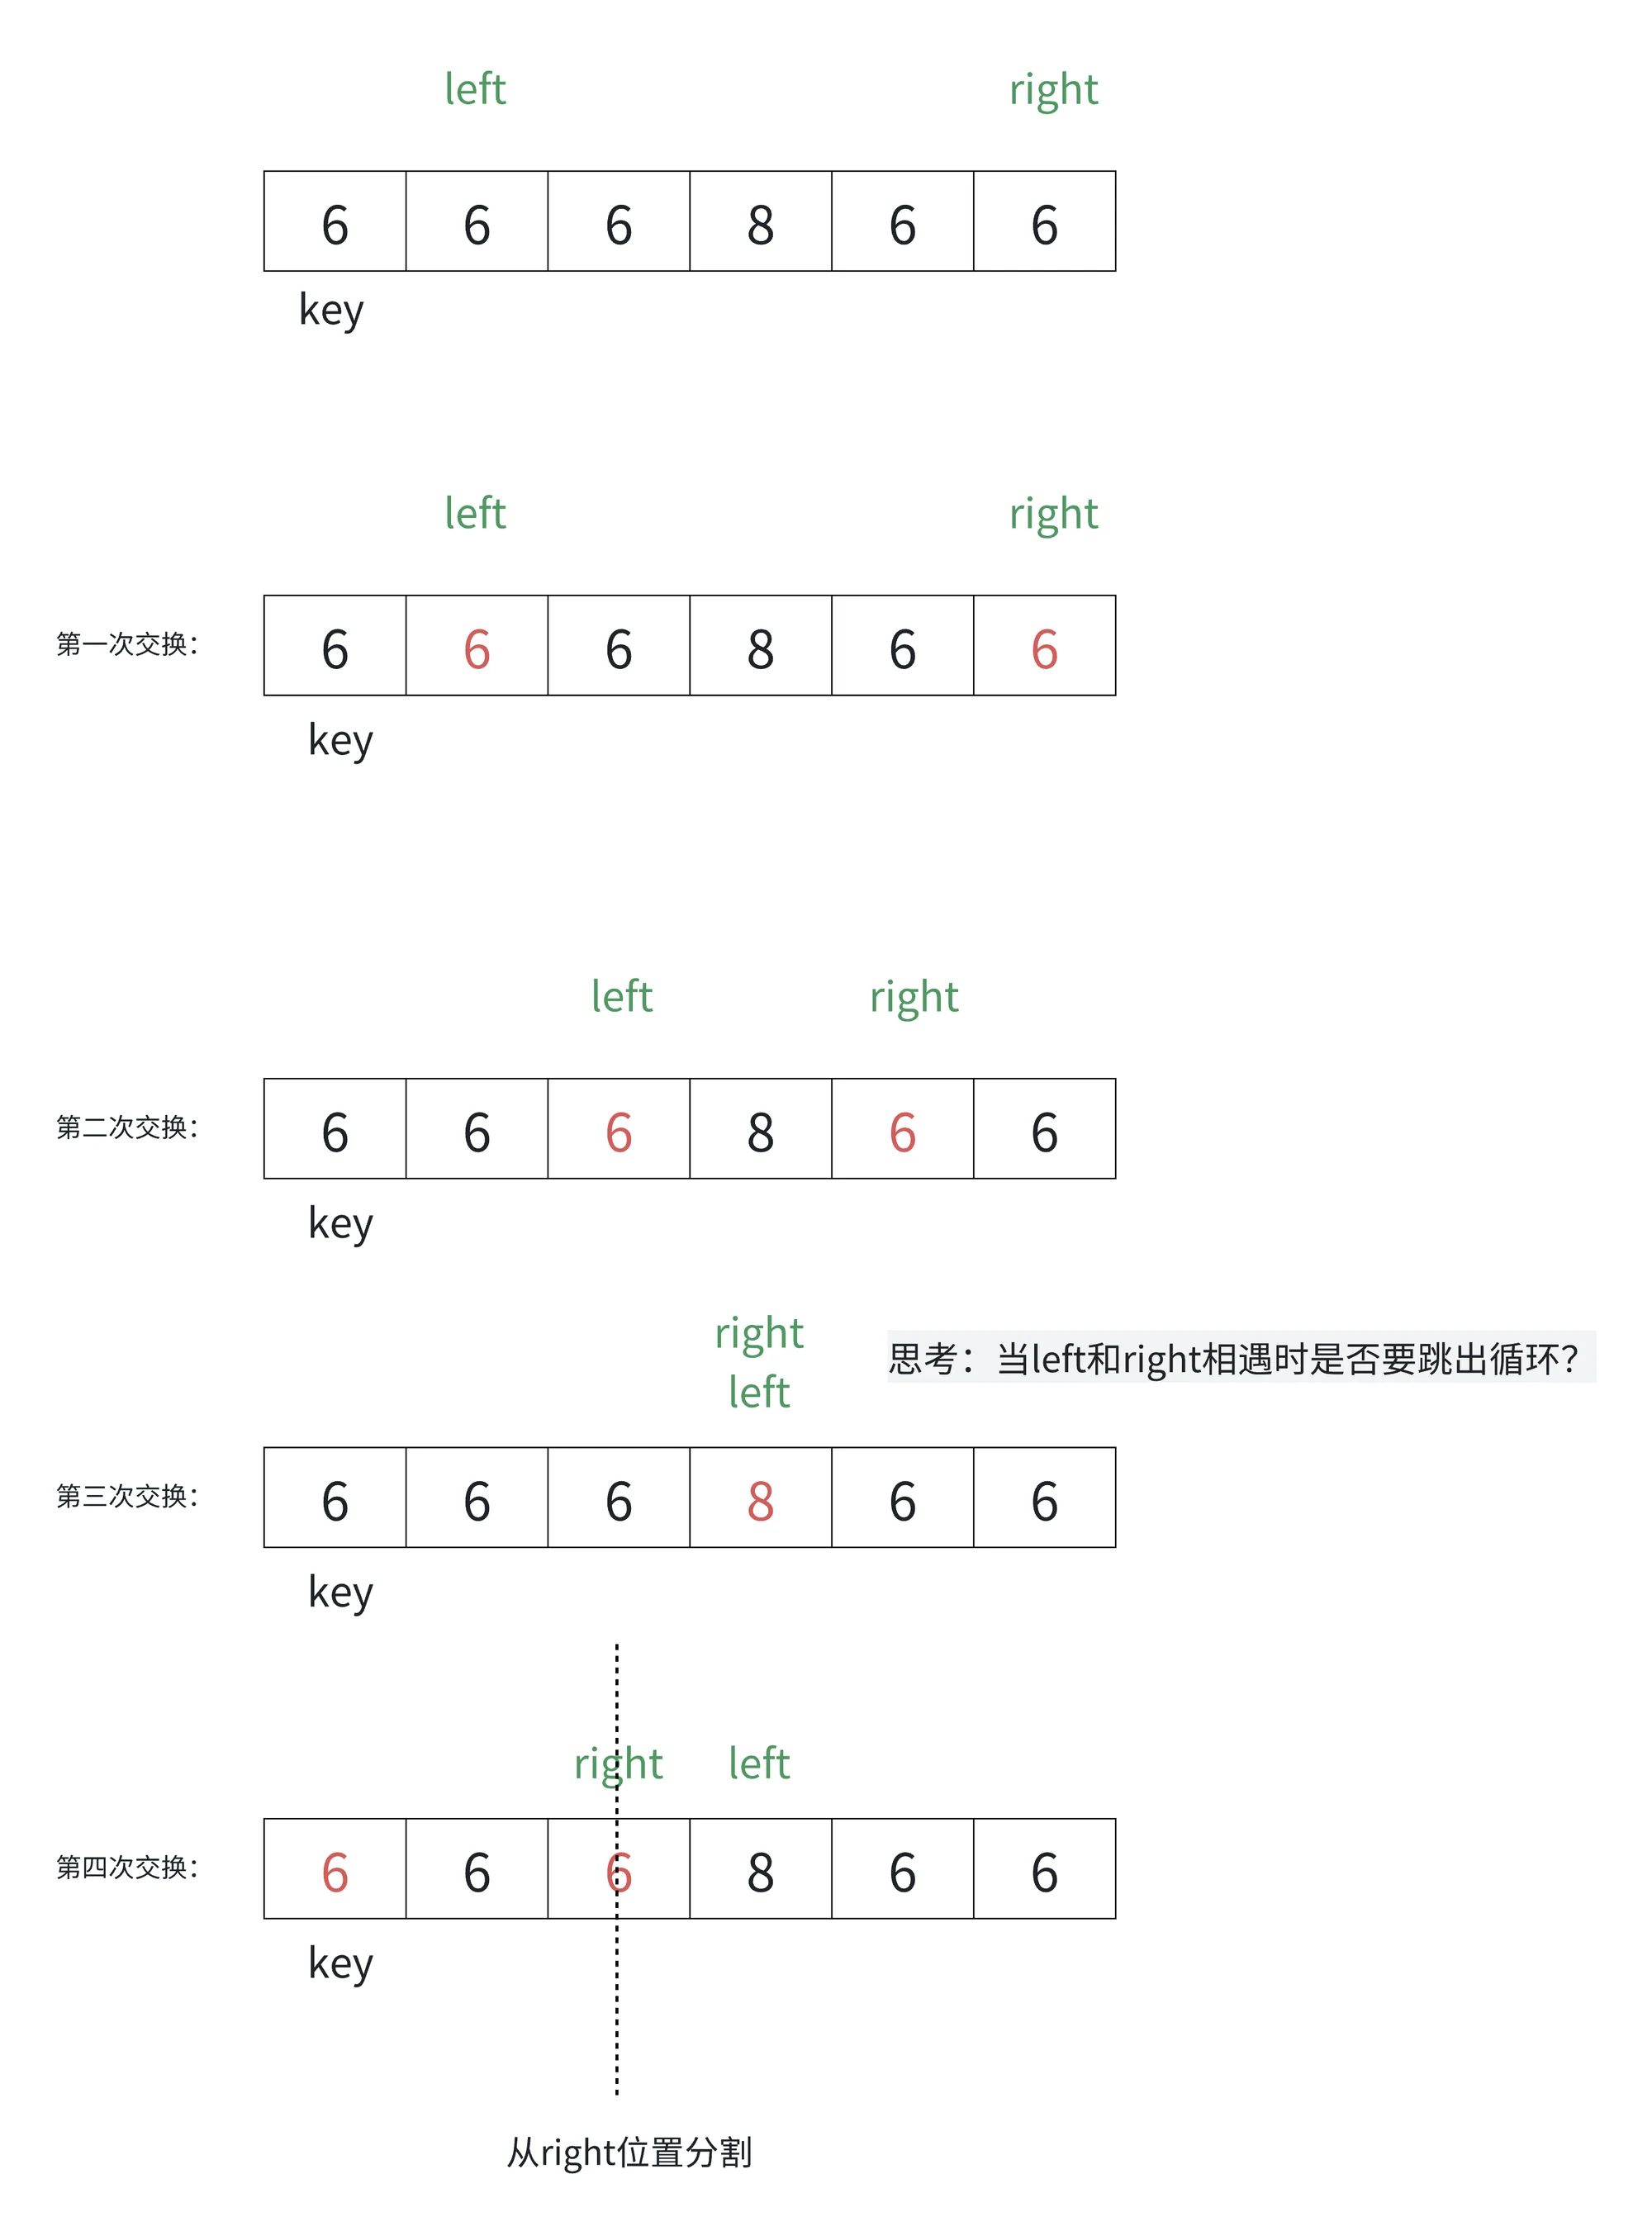
快排的框架是三行:取基准、划分、递归两边。真正容易写错的是划分。课件给了霍尔(Hoare)、挖坑、前后指针(Lomuto)三种,思路不同,边界条件都一样刁。
霍尔划分:右指针先走
static int GetMidIndex(int* a, int left, int right)
{
    int mid = left + (right - left) / 2;   /* 避免 left + right 溢出 */

    if (a[left] > a[mid])
    {
        if (a[mid] > a[right])
            return mid;
        else if (a[left] > a[right])
            return right;
        else
            return left;
    }
    else
    {
        if (a[left] > a[right])
            return left;
        else if (a[mid] > a[right])
            return right;
        else
            return mid;
    }
}

int PartHoare(int* a, int left, int right)
{
    int midi = GetMidIndex(a, left, right);
    Swap(&a[left], &a[midi]);

    int keyi = left;
    int key = a[keyi];
    ++left;

    while (left <= right)
    {
        while (left <= right && a[right] > key)
            --right;
        while (left <= right && a[left] < key)
            ++left;

        if (left <= right)
        {
            Swap(&a[left], &a[right]);
            ++left;
            --right;
        }
    }

    Swap(&a[keyi], &a[right]);
    return right;
}
基准在左边时,必须让右指针先走。因为要和基准交换的是 right 停下的位置,这个位置上的值必须不大于基准,交换后基准才能落到正确的一侧。如果让左指针先走,它可能停在一个大于基准的值上,交换后基准左边混进一个大元素,整段划分作废。
a[right] > key 和 a[left] < key 都故意不把“等于”算进去。遇到相等就停下来交换,相等的值会被摊到基准两边;如果写成 >= 或 <= 跳过相等,大量重复数据会让指针卡在相等元素上,划分退化成一边倒。
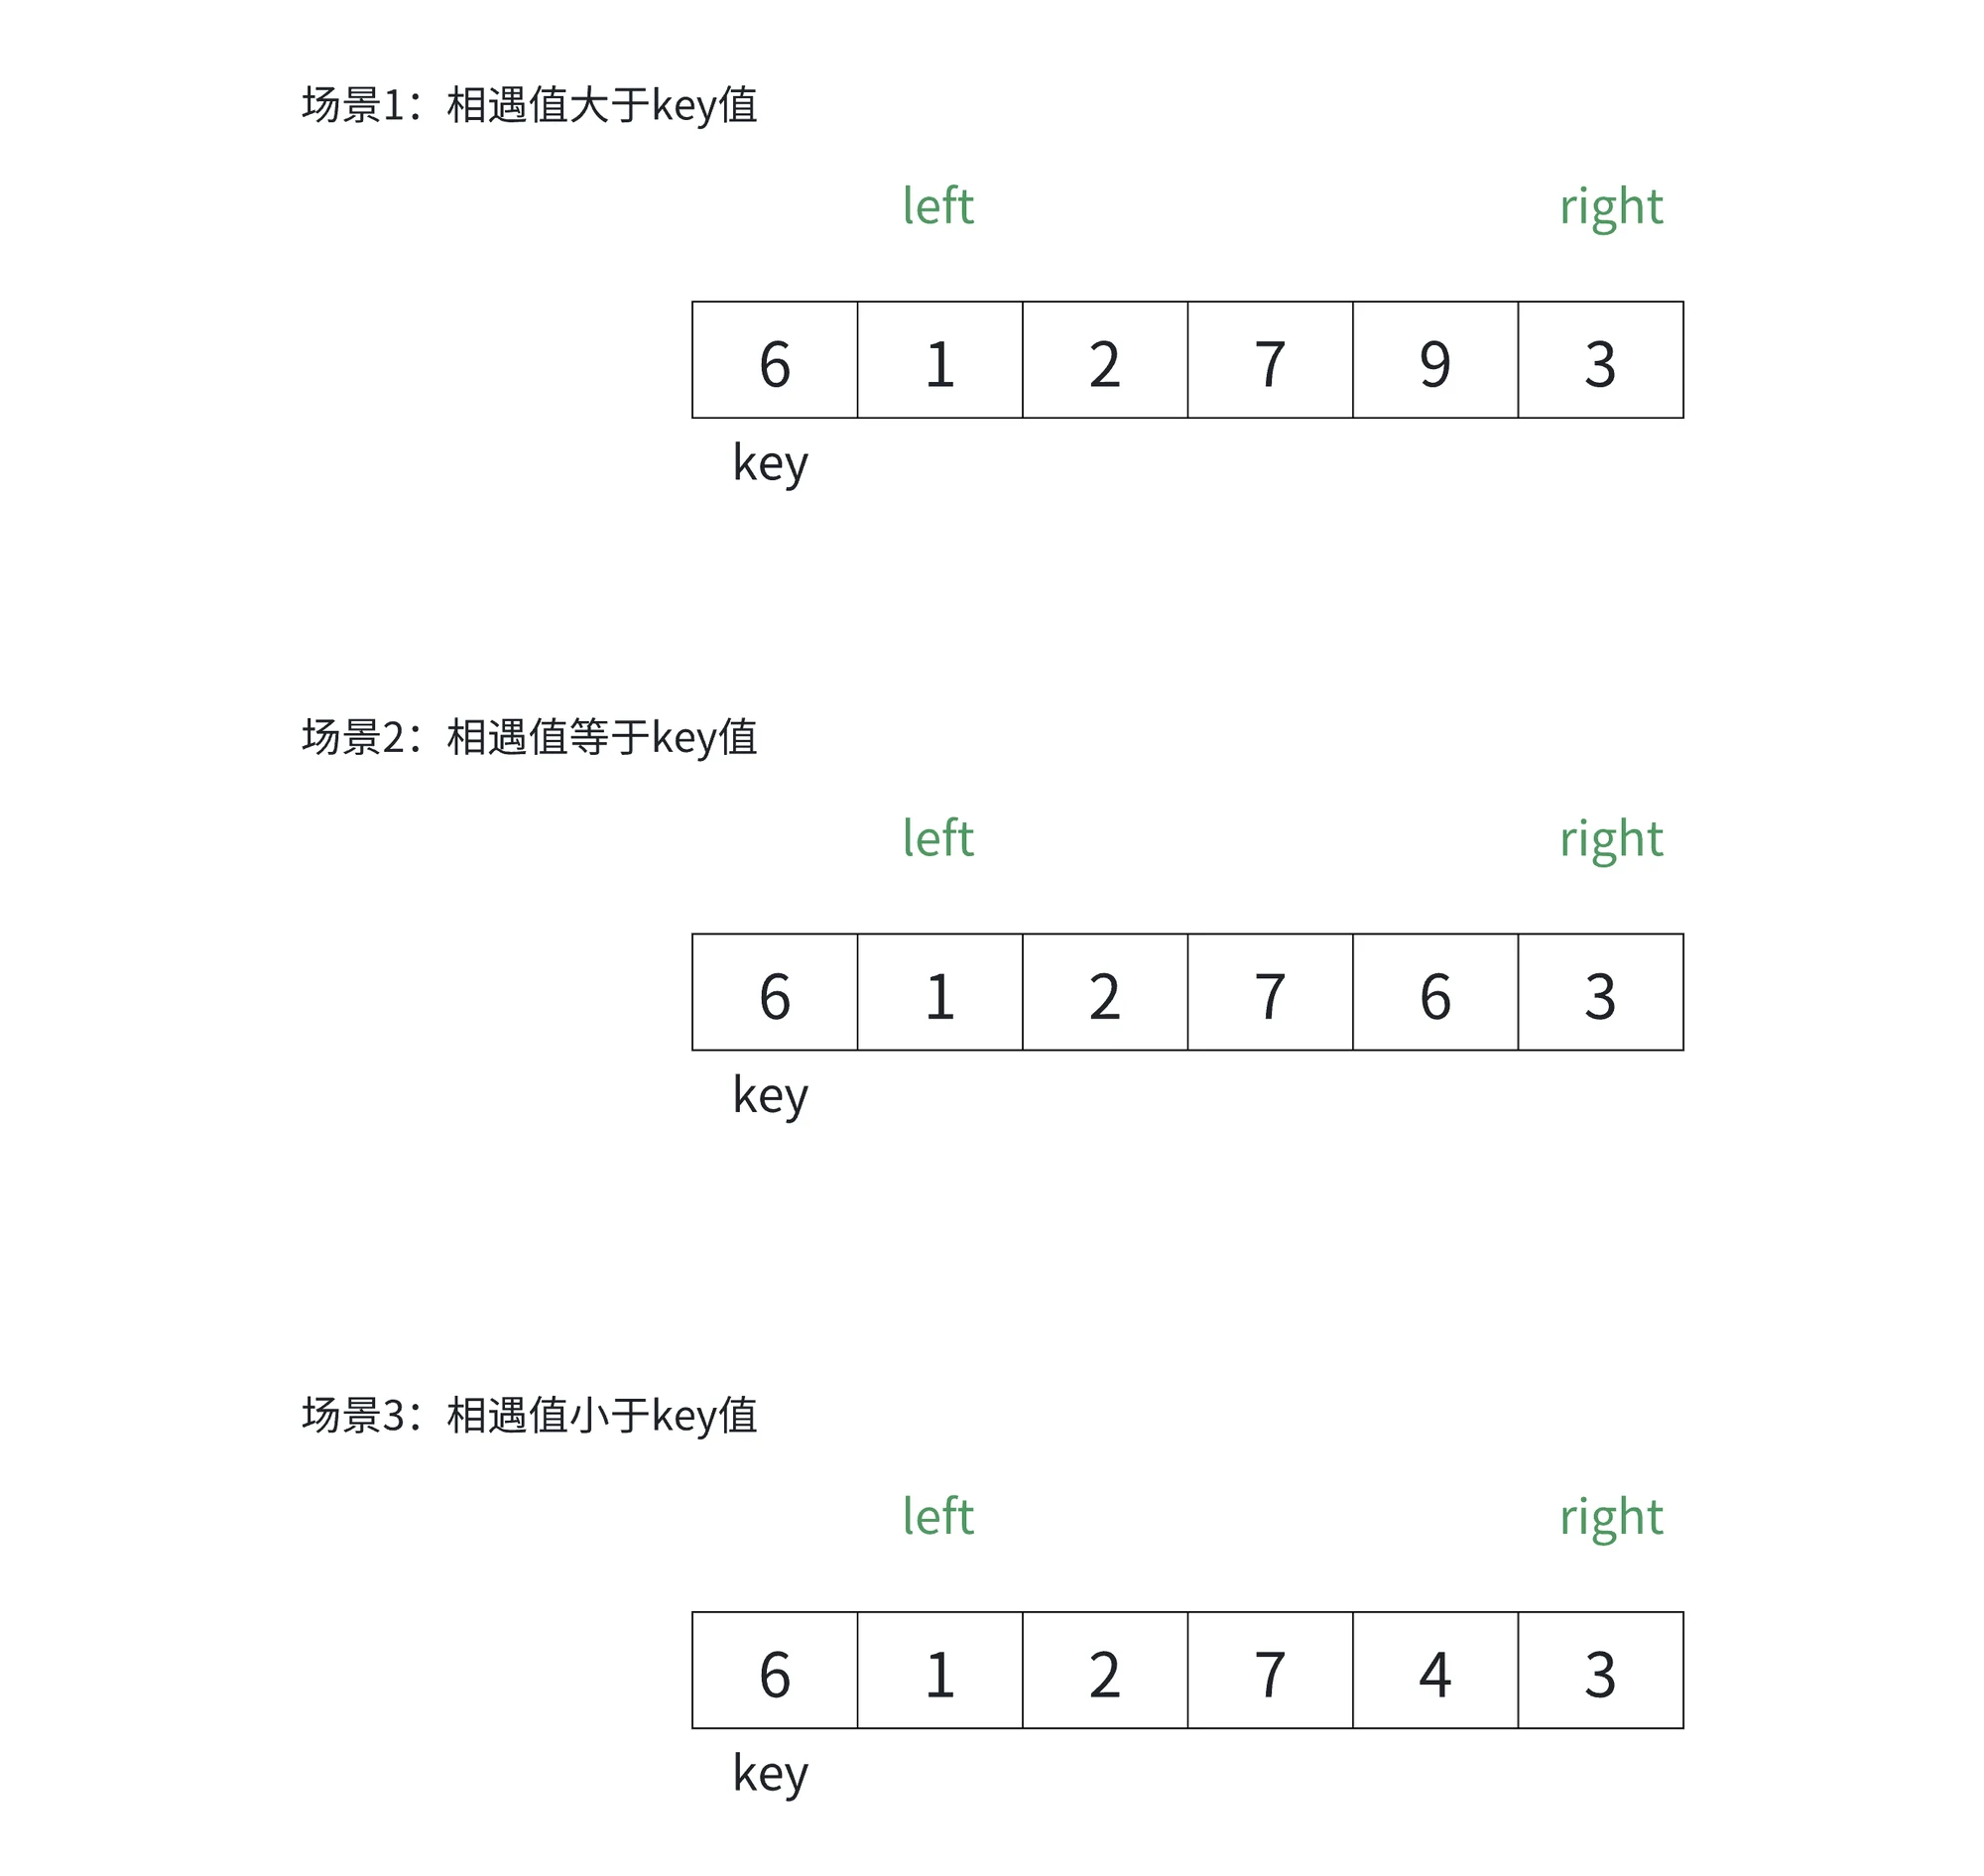
课件这段代码的第二个内层循环注释写成了“右边找小”,实际做的是“左边找大”。注释反了不会让程序出错,但会让人把职责记反,然后顺手把条件写成 <=,相等元素被跳过,划分再次失效。课件主框架的注释还写着“划分 [left,right)”,代码和递归用的却是闭区间 [left,right];这里按闭区间写。
挖坑法:基准取走,留一个洞
int PartHole(int* a, int left, int right)
{
    int key = a[left];
    int hole = left;

    while (left < right)
    {
        while (left < right && a[right] >= key)
            --right;
        a[hole] = a[right];
        hole = right;

        while (left < right && a[left] <= key)
            ++left;
        a[hole] = a[left];
        hole = left;
    }

    a[hole] = key;
    return hole;
}
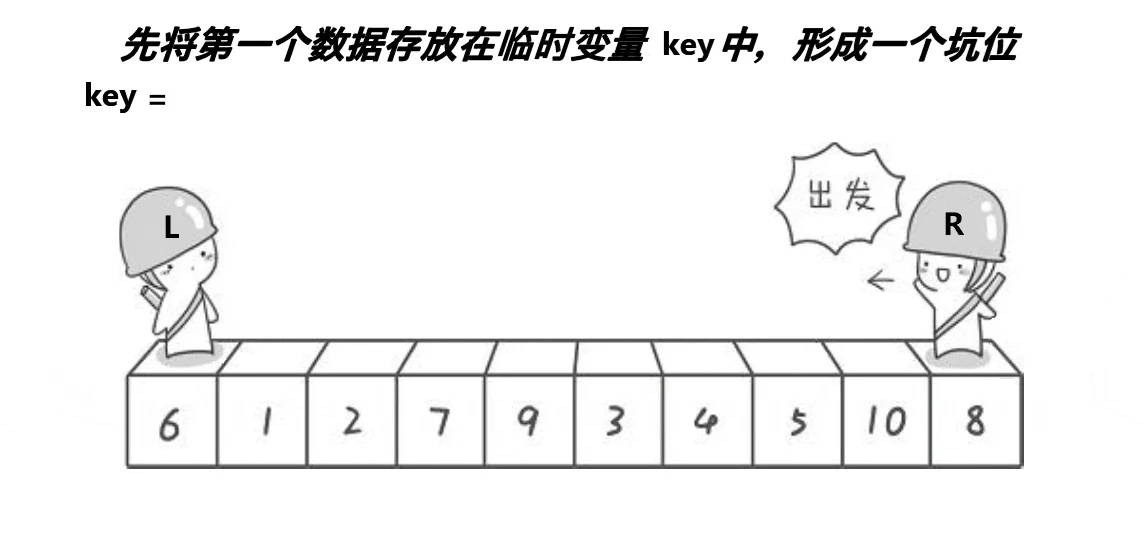
挖坑法把基准先“取出来”,数组头留下一个坑。右指针找到比基准小的数,填进左坑,当前位置变成新坑;左指针找到比基准大的数,填进右坑,当前位置再变成新坑。两个指针相遇时,剩下的坑就是基准的位置。课件代码里有一行 int mid = a[left];,声明之后从没使用,真正的基准是下一行的 key,这行是改代码时的残留,删掉。
前后指针法:让 prev 守住小元素区
int PartLomuto(int* a, int left, int right)
{
    int keyi = left;
    int prev = left;

    for (int cur = left + 1; cur <= right; ++cur)
    {
        if (a[cur] < a[keyi] && ++prev != cur)
            Swap(&a[cur], &a[prev]);
    }

    Swap(&a[keyi], &a[prev]);
    return prev;
}
prev 始终停在“已确认的小元素区”末尾,cur 从左往右扫。++prev != cur 用短路避免自己和自己交换。它在全相等数据上会退化:条件 a[cur] < a[keyi] 一个都不成立,基准每次落在最左端,递归深度变成 n,时间复杂度回到 O(n²)。霍尔版本因为相等也交换,反而能把相等元素摊到两边。
三数取中与小区间插入
三数取中从 left、mid、right 三个位置里选出值居中的那个,换到 left 当基准。它能避开“已经有序”“完全逆序”这两种最常见的退化输入,但不能消灭最坏情况:专门构造的数据仍能让快排退到 O(n²)。快排的平均和最好时间是 O(n log n),最坏 O(n²),递归栈平均 O(log n)、最坏 O(n)。课件只写了 O(nlogn) 和 O(logn),没提最坏情况,面试里通常会被追问。
小区间优化是另一笔账:递归到长度很小的区间时,快排的递归调用和划分开销已经超过插入排序。常见做法是长度小于等于 10 时直接调用 InsertSort,不再继续划分。
void QuickSort(int* a, int left, int right)
{
    if (left >= right)
        return;

    if (right - left + 1 <= 10)
    {
        InsertSort(a + left, right - left + 1);
        return;
    }

    int meet = PartHoare(a, left, right);
    QuickSort(a, left, meet - 1);
    QuickSort(a, meet + 1, right);
}
非递归版本
非递归快排用一个显式栈保存待划分的区间。区间用结构体表示,栈的容量按最坏情况开 n + 2 个,避免递归深度退化时溢出。
typedef struct
{
    int left;
    int right;
} Range;

void QuickSortNonR(int* a, int left, int right)
{
    if (left >= right)
        return;

    int cap = right - left + 2;
    Range* st = (Range*)malloc(sizeof(Range) * (size_t)cap);
    if (st == NULL)
        return;

    int top = 0;
    st[top++] = (Range){left, right};

    while (top > 0)
    {
        Range r = st[--top];
        if (r.left >= r.right)
            continue;

        int meet = PartHoare(a, r.left, r.right);
        if (r.left < meet - 1)
            st[top++] = (Range){r.left, meet - 1};
        if (meet + 1 < r.right)
            st[top++] = (Range){meet + 1, r.right};
    }

    free(st);
}
先压左区间还是先压右区间不影响正确性,只影响处理顺序;每个区间出栈时独立划分,和递归版本等价。栈的深度最坏是 O(n),空间和递归版的最坏情况一样。
归并(merge sort):先切到单元素,再两两合并
归并排序(Merge sort)是分治的典型应用:把序列对半切开,分别排好,再把两个有序段合并成一个有序段。合并时相等就取左段,左段元素本来就在前面,所以归并稳定。
void _MergeSort(int* a, int left, int right, int* tmp)
{
    if (left >= right)
        return;

    int mid = left + (right - left) / 2;   /* 不用 (left + right) / 2 */
    _MergeSort(a, left, mid, tmp);
    _MergeSort(a, mid + 1, right, tmp);

    int i = left, j = mid + 1, k = left;
    while (i <= mid && j <= right)
    {
        if (a[i] <= a[j])
            tmp[k++] = a[i++];
        else
            tmp[k++] = a[j++];
    }

    while (i <= mid)
        tmp[k++] = a[i++];
    while (j <= right)
        tmp[k++] = a[j++];

    for (int t = left; t <= right; ++t)
        a[t] = tmp[t];
}

void MergeSort(int* a, int n)
{
    if (n <= 1)
        return;

    int* tmp = (int*)malloc(sizeof(int) * (size_t)n);
    if (tmp == NULL)
        return;

    _MergeSort(a, 0, n - 1, tmp);
    free(tmp);
}
课件 _MergeSort 里写的是 int mid = (right + left) / 2;。left + right 在元素个数接近 INT_MAX 时会溢出成负数,mid 随之错位,递归切分出非法区间。改成 left + (right - left) / 2 就不会溢出。
课件合并时写的是 if (a[begin1] < a[begin2]),相等时取右段,右段元素先出,左段原本靠前的相等元素被排到后面,归并排序立刻不稳定。把 < 改成 <=,相等取左段,稳定性才回来。稳定性就藏在这一个符号里。
课件 MergeSort 里用的是 new int[n] 和 delete[] tmp,这是 C++ 语法,放进 .c 文件编译不过。C 版本用 malloc 加 free,并检查返回值。
非递归归并从长度 1 开始,两两合并,再把段长翻倍:
void MergeSortNonR(int* a, int n)
{
    if (n <= 1)
        return;

    int* tmp = (int*)malloc(sizeof(int) * (size_t)n);
    if (tmp == NULL)
        return;

    for (int gap = 1; gap < n; gap *= 2)
    {
        for (int i = 0; i < n; i += 2 * gap)
        {
            int left1 = i;
            int right1 = i + gap - 1;
            int left2 = i + gap;
            int right2 = i + 2 * gap - 1;

            if (right1 >= n)
                right1 = n - 1;
            if (left2 >= n)
                left2 = n;
            if (right2 >= n)
                right2 = n - 1;

            int k = i;
            int p1 = left1;
            int p2 = left2;

            while (p1 <= right1 && p2 <= right2)
            {
                if (a[p1] <= a[p2])
                    tmp[k++] = a[p1++];
                else
                    tmp[k++] = a[p2++];
            }

            while (p1 <= right1)
                tmp[k++] = a[p1++];
            while (p2 <= right2)
                tmp[k++] = a[p2++];

            for (int t = i; t < k; ++t)
                a[t] = tmp[t];
        }
    }

    free(tmp);
}边界处理是这一段最容易错的地方:右段可能根本不存在,left2 >= n 时把 left2 设成 n、right2 设成 n - 1,后面的 while 自然不执行;右段可能被截断,right2 要夹到 n - 1。归并的时间恒为 O(n log n),最好、平均、最坏都一样;空间 O(n),那块 tmp 必须提前申请。
计数排序(counting sort):不开比较,直接按值记账
计数排序(Counting sort)不做关键字比较,先统计每个值出现了多少次,再按值从小到大把记录写回原数组。它是哈希直接定址法的变形应用。
void CountSort(int* a, int n)
{
    if (n <= 0)
        return;

    int min = a[0], max = a[0];
    for (int i = 1; i < n; ++i)
    {
        if (a[i] < min)
            min = a[i];
        if (a[i] > max)
            max = a[i];
    }

    int range = max - min + 1;
    int* count = (int*)calloc((size_t)range, sizeof(int));
    if (count == NULL)
        return;

    for (int i = 0; i < n; ++i)
        ++count[a[i] - min];

    int j = 0;
    for (int v = 0; v < range; ++v)
    {
        while (count[v] > 0)
        {
            a[j++] = v + min;
            --count[v];
        }
    }

    free(count);
}
range = max - min + 1,最小值自己也要占一个下标;只写 max - min 会少一格,最大值映射到 range 就越界。时间 O(n + range),空间 O(range),只适合范围集中的整数;范围一大,空间先炸。按值回填的版本对纯整数稳定;如果记录还带其他字段,要保留相同关键字的相对次序,得先做前缀和,再从右往左放置,才是完整的稳定计数排序。
稳定性与复杂度总表
| 算法 | 平均 | 最好 | 最坏 | 辅助空间 | 稳定性 |
|---|---|---|---|---|---|
| 直接插入 | O(n²) | O(n) | O(n²) | O(1) | 稳定 |
| 希尔 | 约 O(n^1.3) | O(n log n) | O(n²) | O(1) | 不稳定 |
| 直接选择 | O(n²) | O(n²) | O(n²) | O(1) | 不稳定 |
| 冒泡 | O(n²) | O(n) | O(n²) | O(1) | 稳定 |
| 堆排序(heap sort) | O(n log n) | O(n log n) | O(n log n) | O(1) | 不稳定 |
| 快速排序 | O(n log n) | O(n log n) | O(n²) | 平均 O(log n),最坏 O(n) | 不稳定 |
| 归并排序 | O(n log n) | O(n log n) | O(n log n) | O(n) | 稳定 |
| 计数排序 | O(n + range) | O(n + range) | O(n + range) | O(range) | 稳定 |
稳定性可以用小例子逐个验证:
- 直接选择:
5a 8 5b 2 9,第一轮2和5a交换,得到2 8 5b 5a 9,两个5反了。 - 希尔:
5a 8 2 5b 9,gap = 2时5a和5b被分到不同组,跨组移动后5b跑到5a前面。 - 堆排序:
2a 2b 1,建大堆后堆顶换到末尾,再下沉,最后得到1 2b 2a。课件用一个全相同的2 2 2 2作为反例,这组数据标不出谁前谁后,换成带标记的2a 2b才看得出不稳定。 - 快速排序:
5 3a 3b 4 3c 8 9 10 11,划分时相等键被换到基准两边,原来的先后次序不保证。 - 归并:合并时
<=取左段,相等元素保持左段在前;改成<立刻不稳定。 - 插入、冒泡:只在严格大于时移动或交换,相等元素不越过彼此,稳定。
- 计数:按值回填的纯整数版本稳定;带卫星数据时要用前缀和从右往左放。
选排序算法跟选数据结构一样,先问清楚“要不要稳定、数据范围多大、内存够不够”,再谈速度。需要稳定又不想自己写,std::stable_sort 在额外内存够用时是 O(n log n);std::sort 更快,但不承诺稳定。比较类算法的下界是 O(n log n),计数排序能突破它,是因为它没有走比较这条路,代价是把值域当成数组下标。
还没有评论 — 第一条由你来留。