先看一组序列:前序 1 2 3 4 5 6,中序 3 2 1 5 4 6。按这两行推后序,左子树是 3 2,右子树是 5 6 4,根 1 在末尾,结果是 3 2 5 6 4 1。课件印的是 3 1 5 6 4 1,里面两个 1、没有 2。这个差异不是排版问题:课件后序函数体里递归调用的是 InOrder,输出自然会乱。
二叉树的所有操作都从一句话长出来:一棵非空二叉树由根结点、根的左子树、根的右子树组成,左子树和右子树各自又是一棵二叉树。递归定义决定了递归写法,也决定了遍历、统计、销毁都能用同一套骨架。
树的术语都能在结点上数出来
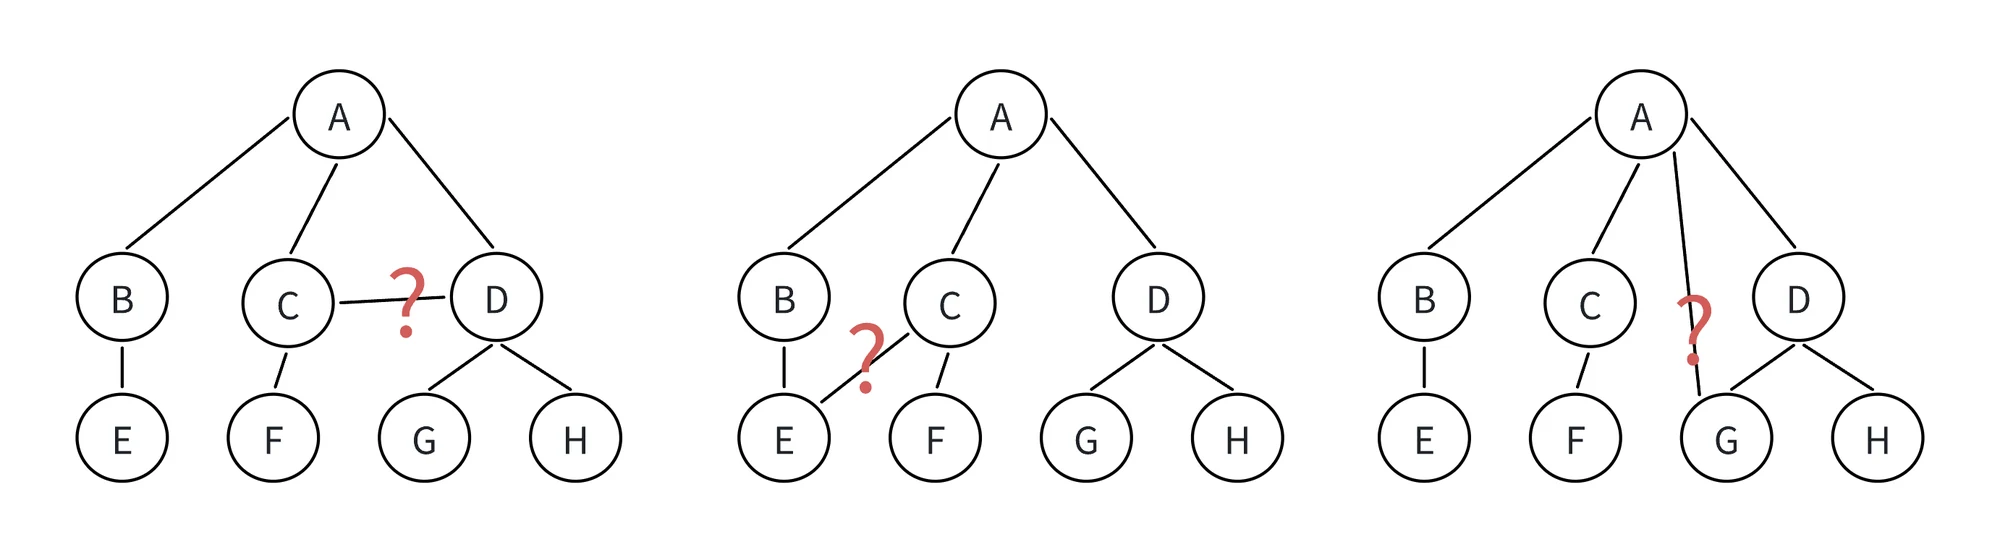
树(tree)是 n 个有限结点组成的具有层次关系的集合,有一个没有前驱的根结点,其余结点被分成若干互不相交的子树。子树之间不能有交集,除根以外每个结点有且只有一个父结点,一棵 N 个结点的树有 N - 1 条边。
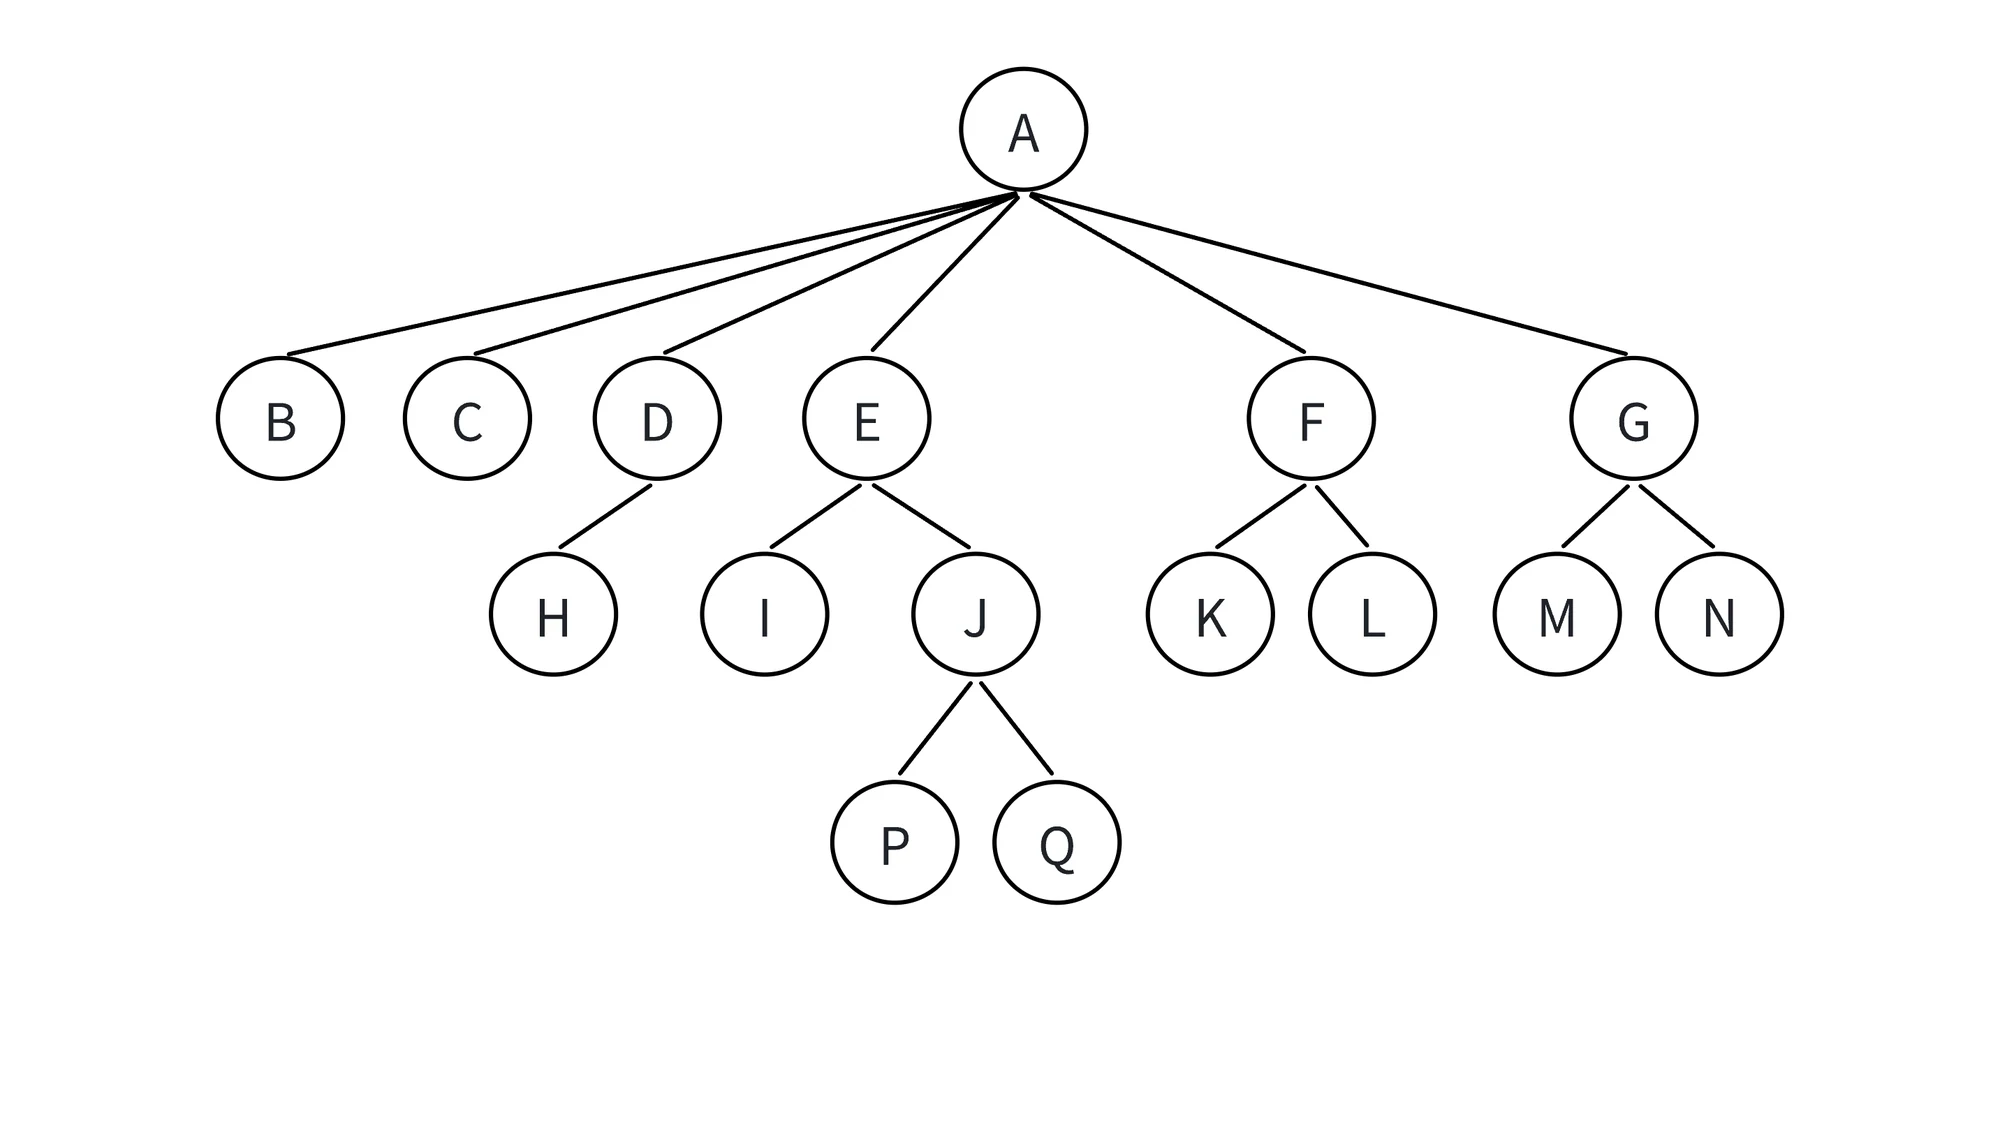
按这张图把术语落到具体结点上:
- 父结点/双亲结点:A 是 B 到 G 的父结点。
- 子结点/孩子结点:B 到 G 都是 A 的孩子。
- 结点的度:一个结点有几个孩子。A 的度是 6,F 的度是 2,K 的度是 0。
- 树的度:树中最大的结点度,这张图里是 6。
- 叶子结点/终端结点:度为 0 的结点。这张图里 B、C、D、H、I、K、L、M、N、P、Q 都是叶子。
- 分支结点/非终端结点:度不为 0 的结点,这张图里 A、E、F、G、J 是分支结点。
- 兄弟结点:有同一个父结点的结点,B 和 C 是兄弟。
- 结点的层次:根为第 1 层,根的孩子为第 2 层,依此类推。
- 树的高度/深度:结点最大层次。A-E-J-P 是 4 层,树高为 4。
- 祖先:从根到该结点经过的所有结点;A 是所有结点的祖先。
- 路径:沿父结点到子结点的连接形成的序列,A 到 Q 的路径是 A-E-J-Q。
- 子孙:以某结点为根的子树中的任一结点。
- 森林:m 棵互不相交的树的集合。
树有多种表示法:双亲表示法、孩子表示法、孩子双亲表示法、孩子兄弟表示法。常用的是孩子兄弟表示法,也叫二叉链表表示法:每个结点只留两个指针,child 指向第一个孩子,brother 指向右边的下一个兄弟。
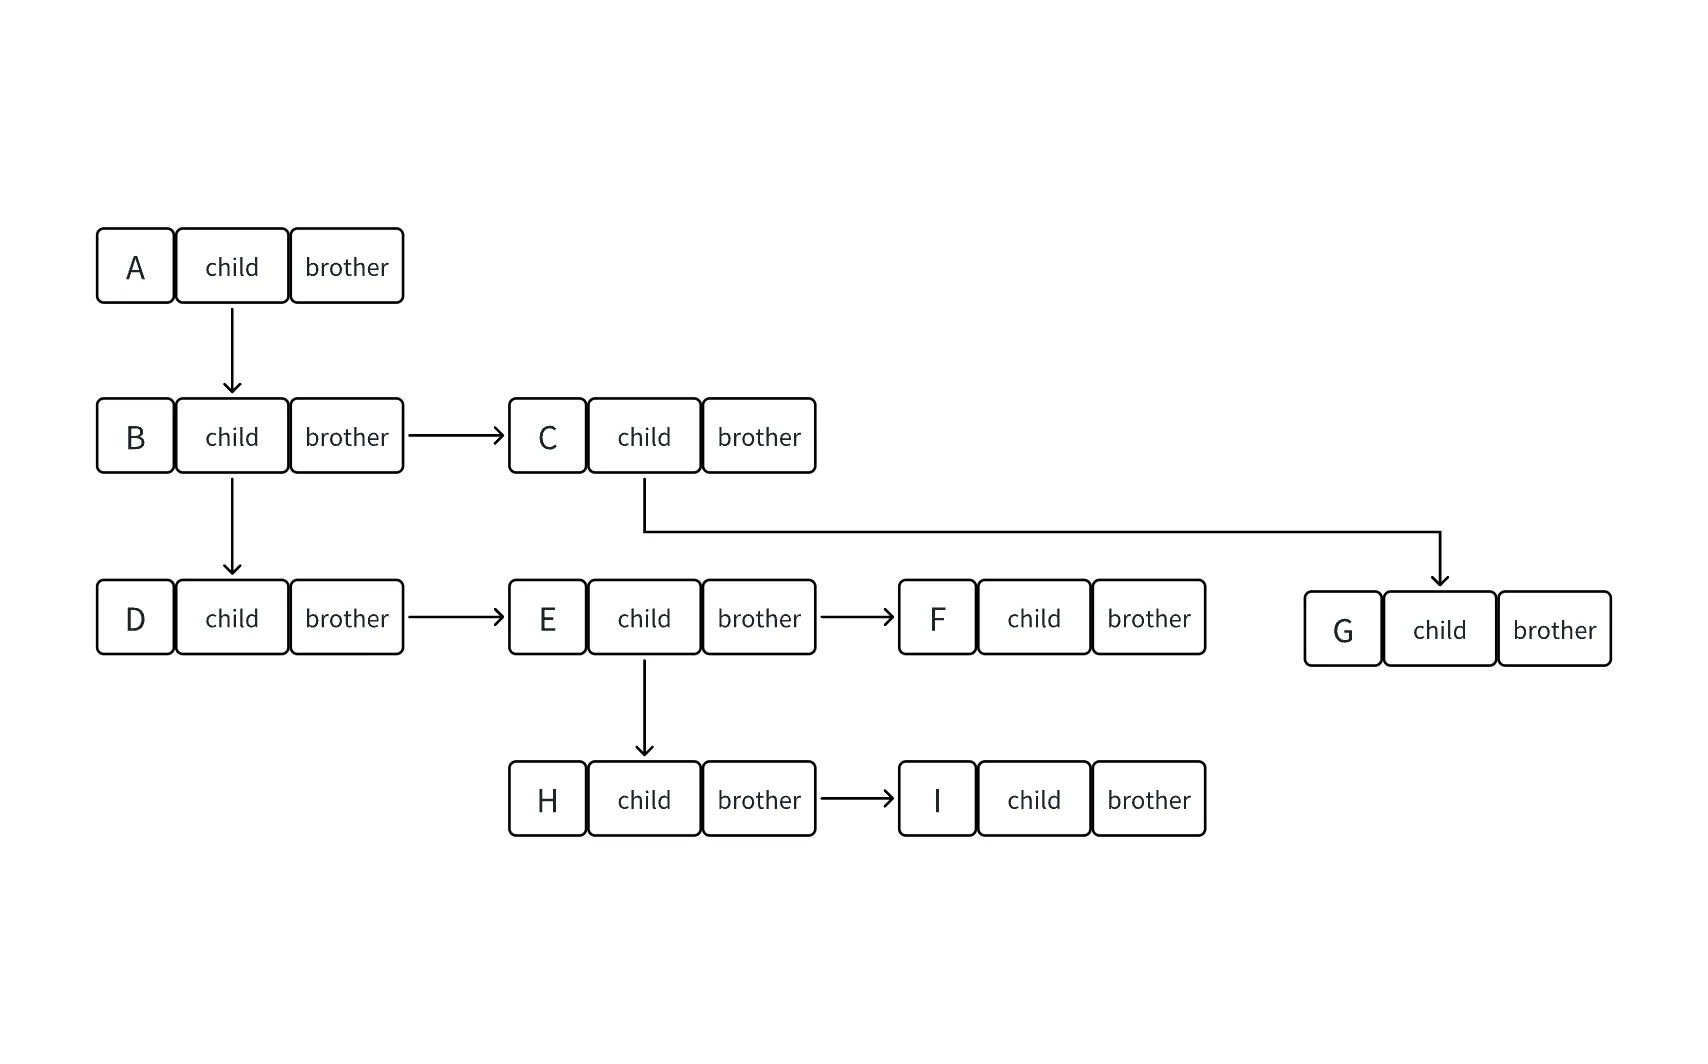
typedef int TreeDataType;

typedef struct TreeNode
{
    struct TreeNode* child;     /* 第一个孩子 */
    struct TreeNode* brother;   /* 右边的下一个兄弟 */
    TreeDataType data;
} TreeNode;
课件把成员写成 struct Node* child、struct Node* brother,而结构体标签叫 TreeNode。struct Node 和 struct TreeNode 是两个不同的不完整类型,编译器会报类型冲突;成员指针必须写成 struct TreeNode*。
文件系统是树形结构的实际应用:根目录是根结点,子目录和文件是孩子,层级关系就是父子关系。Windows 的资源管理器把每个盘符当作一棵树的根,目录一层层往下分。
二叉树(binary tree):非空树 = 根 + 左子树 + 右子树
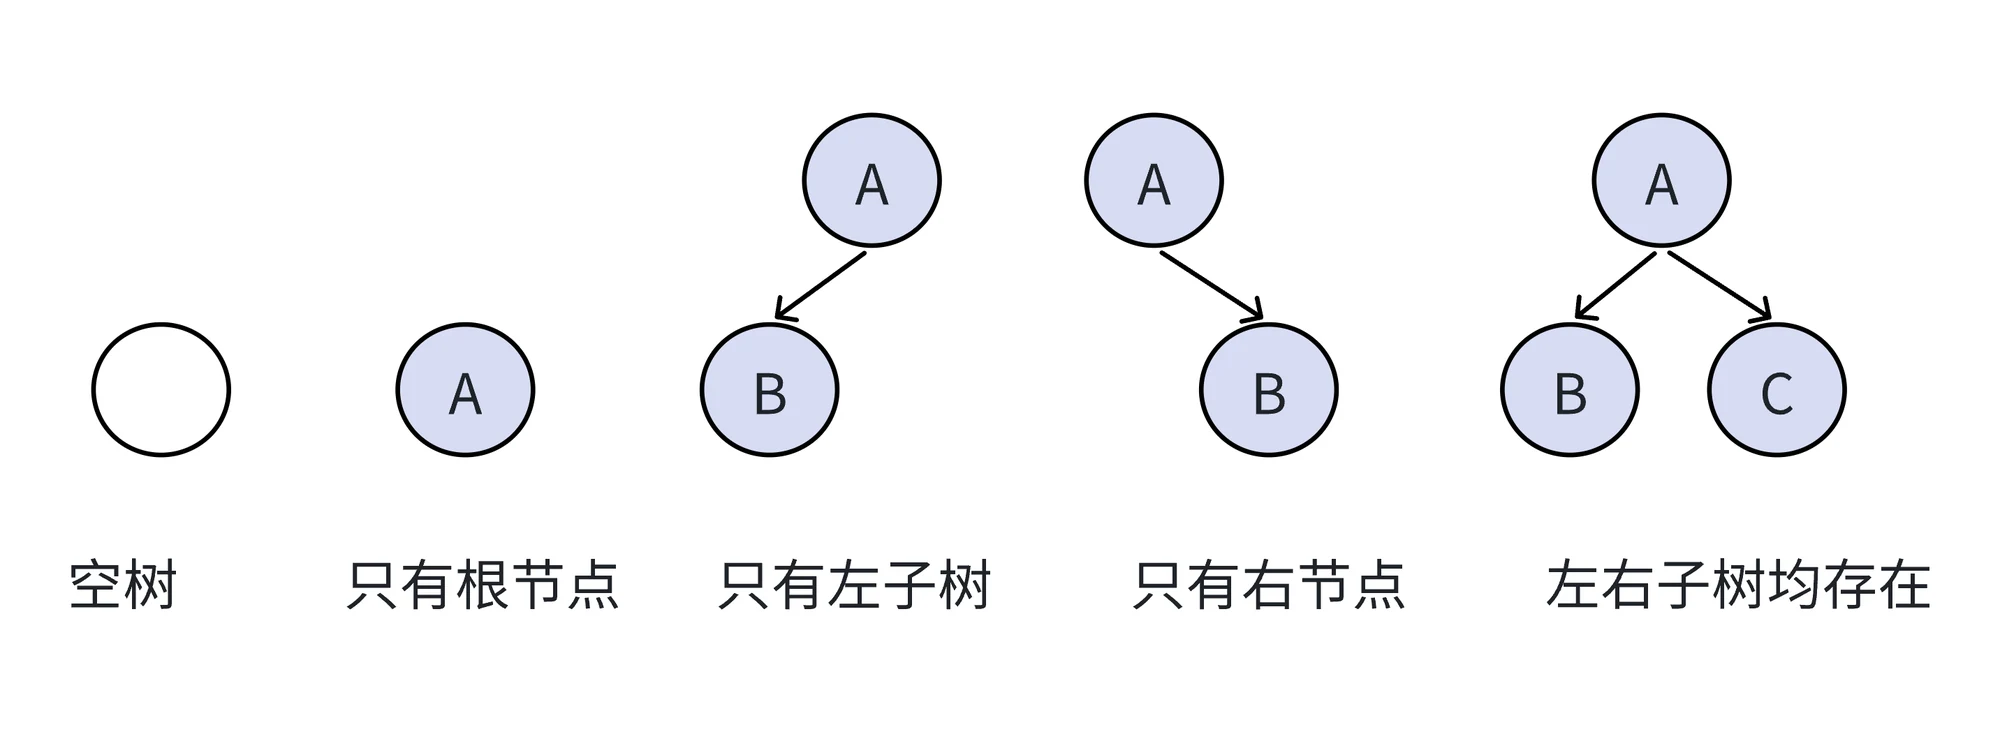
二叉树是结点的一个有限集合,集合要么为空,要么由一个根结点加上两棵分别称为左子树和右子树的二叉树组成。它有两个硬约束:不存在度大于 2 的结点;左右子树有次序,不能颠倒,所以二叉树是有序树。
满二叉树(full binary tree):每一层的结点数都达到最大值。层数为 K 的满二叉树结点总数是 2^K - 1。完全二叉树(complete binary tree):深度为 K、有 n 个结点,当且仅当它的每个结点都与深度为 K 的满二叉树中编号从 1 到 n 的结点一一对应。完全二叉树只允许最底下一层从右往左缺结点,上面几层必须排满;满二叉树是完全二叉树的特例。
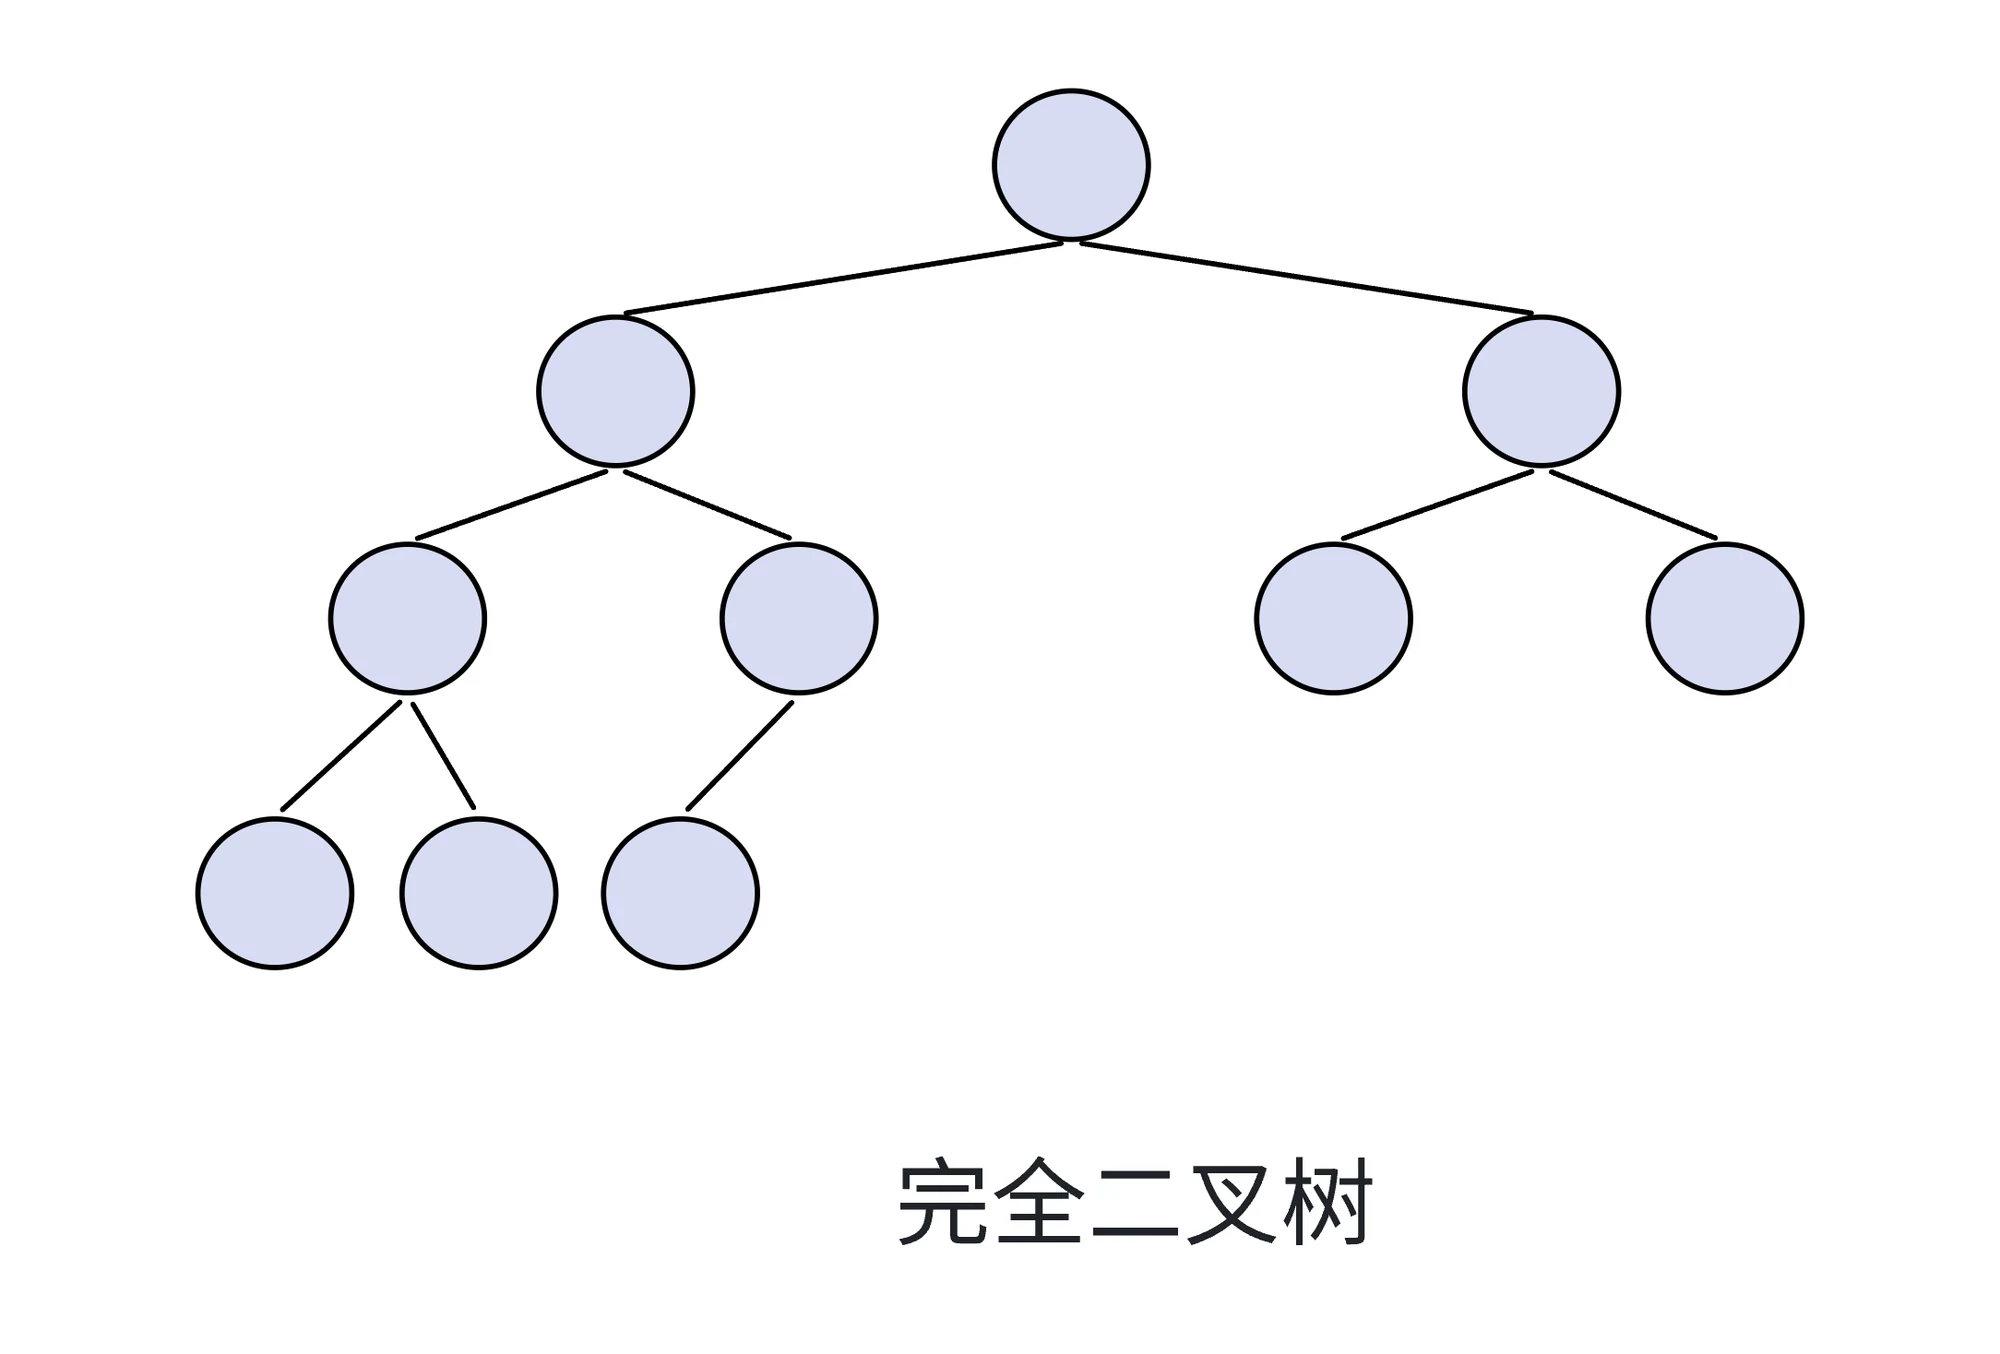
由满二叉树可以直接得到几条性质:
- 根为第 1 层时,第 i 层最多有
2^(i-1)个结点。 - 深度为 h 的二叉树最多有
2^h - 1个结点。 - 有 n 个结点的满二叉树,深度
h = log₂(n + 1)。 - 按从上到下、从左到右从 0 开始编号,序号为 i 的结点,父亲是
(i - 1) / 2,左孩子是2i + 1,右孩子是2i + 2,前提是这些下标没有越界。
还有一条与满二叉树无关的性质:任何二叉树中,度为 0 的结点数 n0 等于度为 2 的结点数 n2 加一。证明只需数两遍边。设度为 2 的结点有 a 个,度为 1 的有 b 个,叶子有 c 个。从每个结点的出边数,总边数是 2a + b;从树的连通性,n 个结点的树有 n - 1 条边,即 a + b + c - 1。两式相等:
2a + b = a + b + c - 1
a = c - 1
用这两条性质可以秒算常见选择题:399 个结点、199 个度为 2 的结点,叶子是 200;有 2n 个结点的完全二叉树,叶子是 n;531 个结点的完全二叉树高度是 10,因为 9 层最多 511 个,10 层能到 1023 个;767 个结点的完全二叉树叶子是 384,因为结点总数是奇数,度为 1 的结点数为 0,767 = n0 + n2 且 n0 = n2 + 1。
三种递归遍历,只差 printf 的位置
前序遍历(preorder traversal):访问根,遍历左子树,遍历右子树。中序遍历(inorder traversal):遍历左子树,访问根,遍历右子树。后序遍历(postorder traversal):遍历左子树,遍历右子树,访问根。三份代码除了 printf 放在哪一行,结构完全相同。
#include <stdio.h>
#include <stdlib.h>

typedef int BTDataType;

typedef struct BinaryTreeNode
{
    struct BinaryTreeNode* left;
    struct BinaryTreeNode* right;
    BTDataType val;
} BTNode;

void PreOrder(BTNode* root)
{
    if (root == NULL)
        return;
    printf("%d ", root->val);
    PreOrder(root->left);
    PreOrder(root->right);
}

void InOrder(BTNode* root)
{
    if (root == NULL)
        return;
    InOrder(root->left);
    printf("%d ", root->val);
    InOrder(root->right);
}

void PostOrder(BTNode* root)
{
    if (root == NULL)
        return;
    PostOrder(root->left);
    PostOrder(root->right);
    printf("%d ", root->val);
}
课件后序函数体里写的是 InOrder(root->left); InOrder(root->right); printf("%d ", root->val);,递归调错了函数。它不会报错,只会让后序变成“中序左 + 中序右 + 打印自己”,输出里出现重复的值。课件里的结点结构体也有标签名问题:结构体叫 BinaryTreeNode,成员却写成 struct BinTreeNode*,两个名字是不同的不完整类型,原样编译不过。
课件的 CreateTree 里建了七个结点,还把结点 7 挂在结点 5 的左边,但后面给出的前序 1 2 3 4 5 6、中序 3 2 1 5 4 6 只覆盖六个结点。按代码建出的树,前序会多出一个 7。下面用六结点版本,结果与课件给的前序、中序一致:
BTNode* BuyNode(BTDataType x)
{
    BTNode* node = (BTNode*)malloc(sizeof(BTNode));
    if (node == NULL)
        return NULL;
    node->val = x;
    node->left = NULL;
    node->right = NULL;
    return node;
}

BTNode* TreeCreate(const int* a, int n, int* pi)
{
    if (*pi >= n || a[*pi] == -1)
    {
        ++(*pi);
        return NULL;
    }

    BTNode* root = BuyNode(a[*pi]);
    if (root == NULL)
        return NULL;
    ++(*pi);
    root->left = TreeCreate(a, n, pi);
    root->right = TreeCreate(a, n, pi);
    return root;
}
用法:
int a[] = {1, 2, 3, -1, -1, -1, 4, 5, -1, -1, 6, -1, -1};
int pi = 0;
BTNode* root = TreeCreate(a, 13, &pi);
这棵树是 1 的左孩子 2、2 的左孩子 3,1 的右孩子 4、4 的左孩子 5、右孩子 6。前序 1 2 3 4 5 6,中序 3 2 1 5 4 6,后序 3 2 5 6 4 1。课件把后序印成 3 1 5 6 4 1,第二个数写错了。
非递归遍历:用显式栈替代调用栈
递归遍历的调用栈由编译器维护;改成非递归,就要自己开一个栈保存“还没处理完的结点”。前序最简单:根入栈,弹栈时访问,先把右孩子入栈,再把左孩子入栈,保证左孩子先出。
int TreeSize(BTNode* root);       /* 定义见下一节 */

void PreOrderNonR(BTNode* root)
{
    int n = TreeSize(root);
    if (n == 0)
    {
        printf("\n");
        return;
    }

    BTNode** st = (BTNode**)malloc(sizeof(BTNode*) * (size_t)n);
    if (st == NULL)
        return;

    int top = 0;
    st[top++] = root;
    while (top > 0)
    {
        BTNode* cur = st[--top];
        printf("%d ", cur->val);
        if (cur->right != NULL)
            st[top++] = cur->right;
        if (cur->left != NULL)
            st[top++] = cur->left;
    }

    free(st);
    printf("\n");
}
中序要把“一路向左”的结点先压栈,弹栈时访问,再转向右子树:
void InOrderNonR(BTNode* root)
{
    int n = TreeSize(root);
    if (n == 0)
    {
        printf("\n");
        return;
    }

    BTNode** st = (BTNode**)malloc(sizeof(BTNode*) * (size_t)n);
    if (st == NULL)
        return;

    int top = 0;
    BTNode* cur = root;
    while (cur != NULL || top > 0)
    {
        while (cur != NULL)
        {
            st[top++] = cur;
            cur = cur->left;
        }
        cur = st[--top];
        printf("%d ", cur->val);
        cur = cur->right;
    }

    free(st);
    printf("\n");
}
后序的非递归要判断“右子树是否已经处理完”。用一个 prev 记录上一个访问的结点:栈顶结点的右孩子存在且不等于 prev,说明右子树还没走,转过去;否则访问栈顶并弹栈。
void PostOrderNonR(BTNode* root)
{
    int n = TreeSize(root);
    if (n == 0)
    {
        printf("\n");
        return;
    }

    BTNode** st = (BTNode**)malloc(sizeof(BTNode*) * (size_t)n);
    if (st == NULL)
        return;

    int top = 0;
    BTNode* cur = root;
    BTNode* prev = NULL;
    while (cur != NULL || top > 0)
    {
        while (cur != NULL)
        {
            st[top++] = cur;
            cur = cur->left;
        }

        BTNode* topNode = st[top - 1];
        if (topNode->right != NULL && topNode->right != prev)
        {
            cur = topNode->right;
        }
        else
        {
            printf("%d ", topNode->val);
            prev = topNode;
            --top;
        }
    }

    free(st);
    printf("\n");
}
层序遍历按“一层一层、从左到右”访问,不能用递归,要借助队列:根入队,每出队一个结点,就把它的左右孩子依次入队。队列的先进先出保证第 k 层的结点排在第 k+1 层前面。
void LevelOrder(BTNode* root)
{
    int n = TreeSize(root);
    if (n == 0)
    {
        printf("\n");
        return;
    }

    BTNode** q = (BTNode**)malloc(sizeof(BTNode*) * (size_t)n);
    if (q == NULL)
        return;

    int front = 0, rear = 0;
    q[rear++] = root;
    while (front < rear)
    {
        BTNode* cur = q[front++];
        printf("%d ", cur->val);
        if (cur->left != NULL)
            q[rear++] = cur->left;
        if (cur->right != NULL)
            q[rear++] = cur->right;
    }

    free(q);
    printf("\n");
}
课件层序遍历用的是 top->data、top->_left、top->_right,而结点字段叫 val、left、right,这两个名字在结构体里都不存在,原样编译不过。QueueDesTroy 也和队列接口里的 QueueDestroy 拼写不一致。
结点数、叶子数、第 k 层、高度、查找
这几个函数都是同一个句式:空树返回 0;非空树把问题拆成左子树和右子树,再合并子问题的答案。
int TreeSize(BTNode* root)
{
    if (root == NULL)
        return 0;
    return 1 + TreeSize(root->left) + TreeSize(root->right);
}

int TreeLeafSize(BTNode* root)
{
    if (root == NULL)
        return 0;
    if (root->left == NULL && root->right == NULL)
        return 1;
    return TreeLeafSize(root->left) + TreeLeafSize(root->right);
}

int TreeLevelKSize(BTNode* root, int k)
{
    if (root == NULL || k <= 0)
        return 0;
    if (k == 1)
        return 1;
    return TreeLevelKSize(root->left, k - 1) +
           TreeLevelKSize(root->right, k - 1);
}

int TreeDepth(BTNode* root)
{
    if (root == NULL)
        return 0;
    int leftDepth = TreeDepth(root->left);
    int rightDepth = TreeDepth(root->right);
    return (leftDepth > rightDepth ? leftDepth : rightDepth) + 1;
}

BTNode* TreeFind(BTNode* root, BTDataType x)
{
    if (root == NULL)
        return NULL;
    if (root->val == x)
        return root;

    BTNode* found = TreeFind(root->left, x);
    if (found != NULL)
        return found;
    return TreeFind(root->right, x);
}
TreeSize 返回 1 + 左子树结点数 + 右子树结点数;TreeLeafSize 只在左右孩子都为空时返回 1,否则把左右子树的叶子数相加;TreeLevelKSize 把 k 减到 1 时返回 1,空树或 k <= 0 返回 0;TreeDepth 取左右子树高度的较大者加 1;TreeFind 按前序查找,左子树找到就返回,找不到再查右子树。
销毁必须后序:先销毁左子树,再销毁右子树,最后释放根。如果先释放根,左右子树的地址就丢了。
void TreeDestroy(BTNode** root)
{
    if (*root == NULL)
        return;
    TreeDestroy(&(*root)->left);
    TreeDestroy(&(*root)->right);
    free(*root);
    *root = NULL;
}
参数用 BTNode**,因为函数要把调用者的根指针置空。只传 BTNode* 的话,函数里 root = NULL 只改副本,调用者仍然拿着已经释放的地址。
堆:完全二叉树的数组下标就是路由
堆(heap)是一种特殊的完全二叉树:每个结点都不大于它的孩子(小根堆),或者都不小于它的孩子(大根堆)。完全二叉树可以塞进数组,中间不留空洞,父子关系直接由下标算出来:i 的父亲是 (i - 1) / 2,左孩子是 2i + 1,右孩子是 2i + 2。这里的堆是数据结构,和操作系统进程地址空间里的“堆”不是一回事。
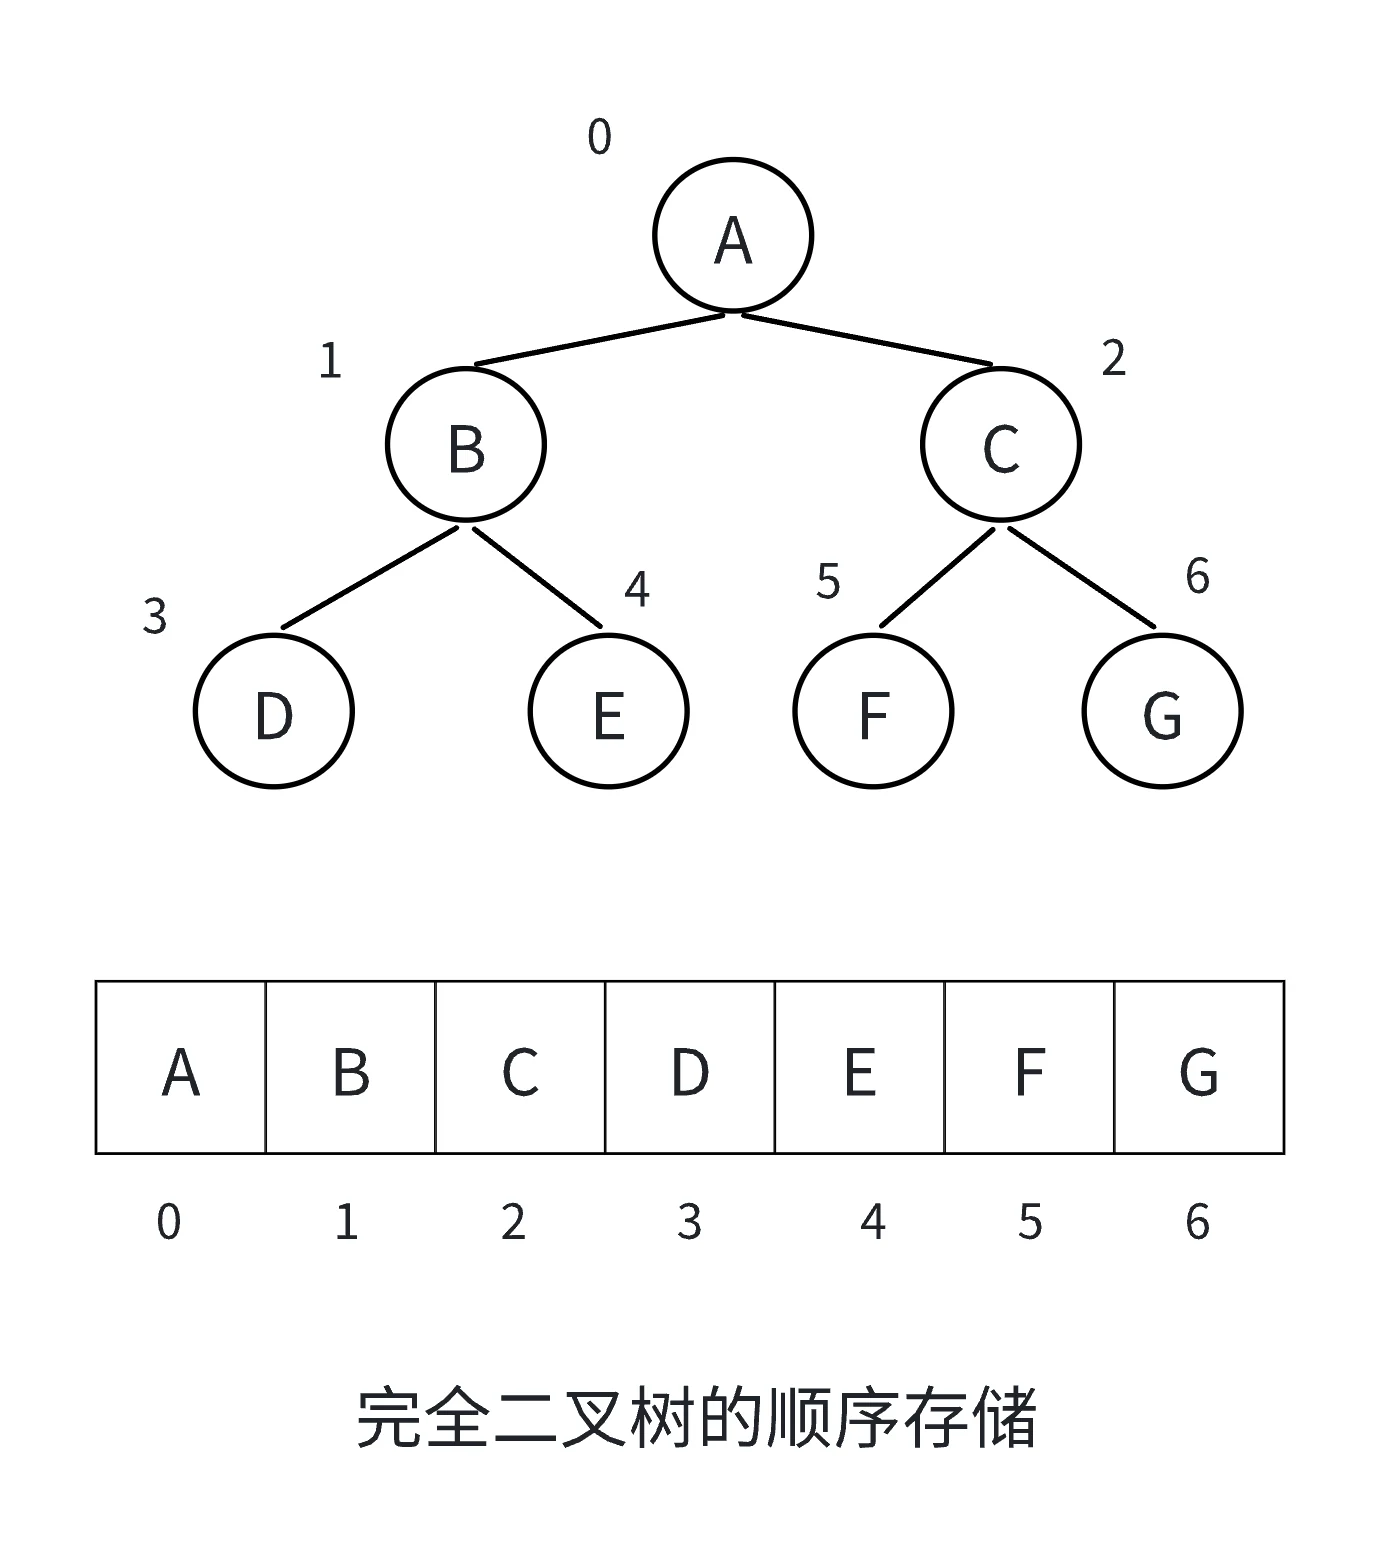
顺序存储只适合完全二叉树。一棵只有右孩子的斜树也得按 2i + 1 的下标留出空位,数组里大半是浪费;链式存储没有这个问题,代价是每个结点多两个指针。
插入时把新元素放到数组末尾,再顺着父亲往上换,直到不再违反堆序:
#include <assert.h>
#include <stdbool.h>

typedef int HPDataType;

typedef struct Heap
{
    HPDataType* a;
    int size;
    int capacity;
} HP;

static void Swap(int* a, int* b)
{
    int t = *a;
    *a = *b;
    *b = t;
}

void AdjustUpMax(HPDataType* a, int child)
{
    int parent = (child - 1) / 2;
    while (child > 0)
    {
        if (a[child] > a[parent])
        {
            Swap(&a[child], &a[parent]);
            child = parent;
            parent = (child - 1) / 2;
        }
        else
        {
            break;
        }
    }
}

void AdjustDownMax(HPDataType* a, int n, int parent)
{
    int child = parent * 2 + 1;
    while (child < n)
    {
        if (child + 1 < n && a[child + 1] > a[child])
            ++child;
        if (a[child] > a[parent])
        {
            Swap(&a[child], &a[parent]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            break;
        }
    }
}
课件 AdjustDown 的注释写“选出左右孩子中小的那个孩子”,代码里却是 a[child + 1] > a[child],选的是较大的孩子。这份实现建的是大根堆,注释写反了不会让程序出错,但会让人把方向记反。小根堆把两处 > 改成 < 即可。
删除堆顶时,先把堆顶和最后一个元素交换,删掉末尾,再让新的堆顶往下沉。往下沉每次要和两个孩子里更合适的那个比,所以必须先选出孩子:
void HPInit(HP* php)
{
    assert(php);
    php->a = NULL;
    php->size = 0;
    php->capacity = 0;
}

void HPDestroy(HP* php)
{
    free(php->a);
    php->a = NULL;
    php->size = 0;
    php->capacity = 0;
}

bool HPEmpty(const HP* php)
{
    return php->size == 0;
}

int HPSize(const HP* php)
{
    return php->size;
}

HPDataType HPTop(const HP* php)
{
    assert(php->size > 0);
    return php->a[0];
}

bool HPPush(HP* php, HPDataType x)
{
    if (php->size == php->capacity)
    {
        int newcap = php->capacity == 0 ? 4 : php->capacity * 2;
        HPDataType* tmp = (HPDataType*)realloc(php->a, sizeof(HPDataType) * (size_t)newcap);
        if (tmp == NULL)
            return false;
        php->a = tmp;
        php->capacity = newcap;
    }

    php->a[php->size++] = x;
    AdjustUpMax(php->a, php->size - 1);
    return true;
}

bool HPPop(HP* php)
{
    if (php->size == 0)
        return false;

    Swap(&php->a[0], &php->a[php->size - 1]);
    --php->size;
    AdjustDownMax(php->a, php->size, 0);
    return true;
}

bool HPInitArray(HP* php, HPDataType* a, int n)
{
    php->a = (HPDataType*)malloc(sizeof(HPDataType) * (size_t)(n == 0 ? 1 : n));
    if (php->a == NULL)
        return false;

    for (int i = 0; i < n; ++i)
        php->a[i] = a[i];
    php->size = n;
    php->capacity = n == 0 ? 1 : n;

    for (int i = (n - 2) / 2; i >= 0; --i)
        AdjustDownMax(php->a, n, i);
    return true;
}
一次上浮或下沉,最多走树的高度,也就是 log₂n 步。它只沿着一条路径走,不是扫描整层:每步只比较父子几个结点,所以代价是树高,不是结点数。HPPush 的扩容均摊 O(1),HPPop 是 O(log n)。
建堆的复杂度要分两种做法,不能只记一个数字:
- 逐个插入并向上调整:插入 n 次,每次最多
log n步,总时间O(n log n)。课上“向上调整算法建堆”说的就是这一种。 - 从最后一个非叶结点
(n - 2) / 2开始,倒着对每个结点向下调整:底层结点几乎不用动,只有靠近根的几个走得远。按层数算,总步数是2^h - h - 1 = n - h,也就是O(n)。std::make_heap这类自底向上的建堆用的就是这一种。
所以“建堆是 O(n)”指的是自底向下调整;“逐个插入建堆是 O(n log n)”也没有错,两者是不同的建堆方式。课件在向上调整一节给出 O(n log n),在向下调整一节给出 O(n),两个结论都对,前提是别把方法混在一起。
有了 O(n) 建堆,堆排序(heap sort)才有意义。升序建大堆,每次把堆顶换到末尾,再对剩下的部分向下调整:
void HeapSort(int* a, int n)
{
    for (int i = (n - 2) / 2; i >= 0; --i)
        AdjustDownMax(a, n, i);

    for (int end = n - 1; end > 0; --end)
    {
        Swap(&a[0], &a[end]);
        AdjustDownMax(a, end, 0);
    }
}
建堆 O(n),之后 n 次取堆顶并下沉,每次 log n,总时间 O(n log n),空间 O(1)。升序建大堆,因为每次把堆顶换到尾部,放过去的正好是当前最大值;建小堆会把最小值排到末尾,得到降序。课件说“堆排序第二个循环中的向下调整与建堆中的向上调整时间复杂度计算一致”,这两个循环并不一致:排序循环是 n 次独立的 O(log n) 下沉,建堆是一次性自底向上的 O(n) 调整,结论碰巧都是 O(n log n) 和 O(n) 的组合,推导过程不能混用。
TOP-K:筛最大的,反而要建小根堆
求前 k 个最大的元素,数据量可能大到装不下内存。做法是:先用前 k 个元素建一个小根堆,堆顶是这 k 个数里最小的那个;剩下的数每读一个,只要比堆顶大,就替换堆顶并向下调整。读完之后,留在堆里的就是前 k 大。
void AdjustDownMin(int* a, int n, int parent)
{
    int child = parent * 2 + 1;
    while (child < n)
    {
        if (child + 1 < n && a[child + 1] < a[child])
            ++child;
        if (a[child] < a[parent])
        {
            Swap(&a[child], &a[parent]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            break;
        }
    }
}

void TopK(const char* filename, int k)
{
    if (k <= 0)
        return;

    FILE* fin = fopen(filename, "r");
    if (fin == NULL)
    {
        perror("fopen");
        return;
    }

    int* heap = (int*)malloc(sizeof(int) * (size_t)k);
    if (heap == NULL)
    {
        fclose(fin);
        return;
    }

    for (int i = 0; i < k; ++i)
    {
        if (fscanf(fin, "%d", &heap[i]) != 1)
        {
            fclose(fin);
            free(heap);
            return;
        }
    }

    for (int i = (k - 2) / 2; i >= 0; --i)
        AdjustDownMin(heap, k, i);

    int x;
    while (fscanf(fin, "%d", &x) == 1)
    {
        if (x > heap[0])
        {
            heap[0] = x;
            AdjustDownMin(heap, k, 0);
        }
    }

    for (int i = 0; i < k; ++i)
        printf("%d ", heap[i]);
    printf("\n");

    free(heap);
    fclose(fin);
}
课件 TOP-K 的注释写着“建 k 个数据的小堆”,代码却直接复用了前面那份 AdjustDown。那份实现选较大的孩子、孩子比父亲大才交换,建出来的是大根堆;再配合 if (x > minheap[0]) 的替换条件,只有比当前最大值还大的数才能进来。结果是:前 k 名里混进了一开始那几个小数字,真正该入选的中间值全被挡在门外。修法只有一处:把比较方向反过来,建堆时选较小的孩子,替换条件保持“比堆顶大”。
时间上,前 k 个建堆 O(k),剩下 n - k 个元素每个比较一次、必要时下沉 O(log k),总代价 O(k + (n - k) log k),空间 O(k)。课件写成 O(n) = k + (n - k) log₂k,左边那个 O(n) 不对:k 很小时接近线性,但一般情况下是 O(n log k)。
判断用大堆还是小堆,别背“最大建小堆”这种口诀,从不变式出发:堆里始终留着“目前见过的 k 个最大元素”,那么堆顶就必须是这 k 个里最小的,才能被下一个更大的数替换掉。想清楚这一点,方向就不会反。
还没有评论 — 第一条由你来留。