栈(stack)和队列(queue)都是操作受限的线性表。栈只允许在一端插入和删除,遵守后进先出(Last In First Out,LIFO);队列一端插入、另一端删除,遵守先进先出(First In First Out,FIFO)。受限不是缺点,它把“下一步该处理谁”这件事固定下来,很多流程就不需要额外记状态。
栈:只在栈顶动手
栈顶是允许插入和删除的那一端,另一端叫栈底。压栈(push)在栈顶放元素,出栈(pop)也从栈顶拿走元素。先压进去的元素被后压的元素盖住,必须等上面的都走了才能出来。
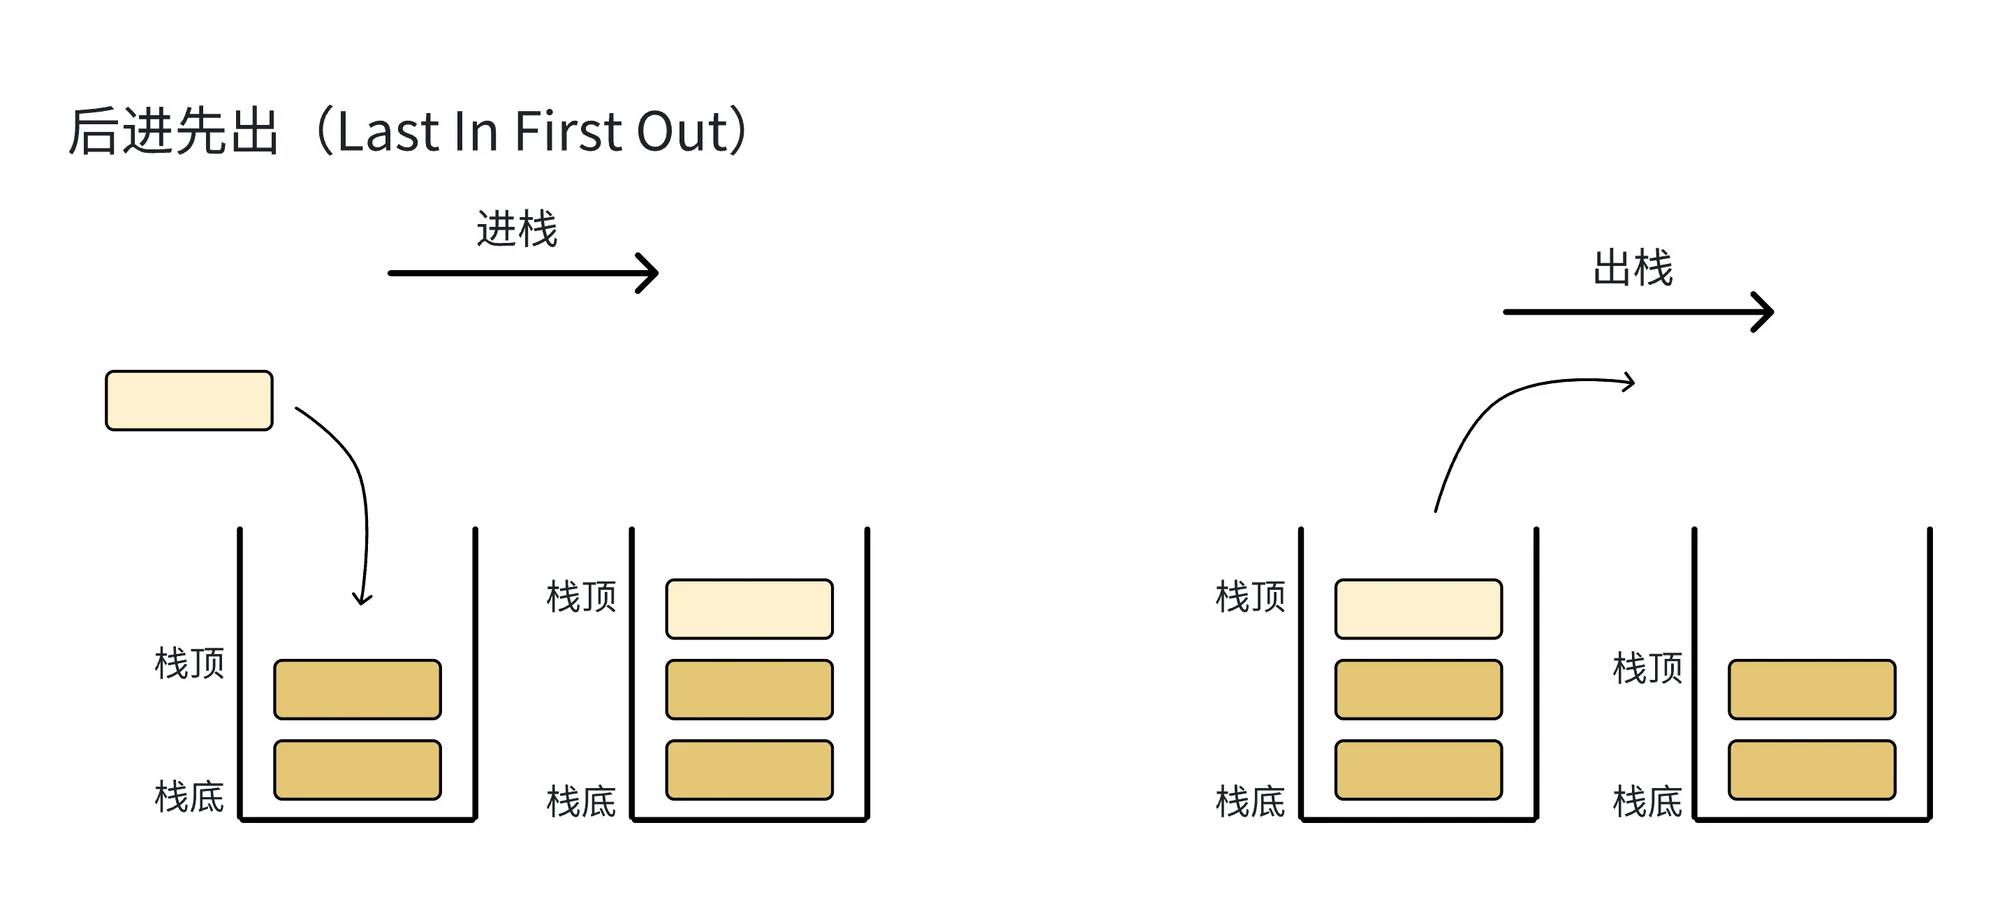
栈可以用数组或链表实现。数组栈在尾部插入删除,不需要为每个元素单独申请结点;链表栈把头当栈顶,头插头删同样是 O(1)。课件说数组更优,理由是“数组在尾上插入代价小”,这个理由只说了一半:链表头插也不慢。真正的差距在别处——数组内存连续、缓存友好,不用每压一个元素就 malloc 一个结点,每个元素也不用额外背一个指针。结论没错,论据要补全。
数组栈的 top 有两种常见约定,选一种写到底:
top指向下一个空位,空栈时top == 0,入栈写a[top++] = x,取顶写a[top - 1]。top指向栈顶元素,空栈时top == -1,入栈写a[++top] = x,取顶写a[top]。
混用会在某些分支里读到未初始化的格子,或者刚好越过容量一位。下面按第一种约定实现:
#include <stdio.h>
#include <stdlib.h>
#include <assert.h>
#include <stdbool.h>

typedef int STDataType;

typedef struct Stack
{
    STDataType* a;
    int top;        /* 下一个空位的下标,空栈为 0 */
    int capacity;
} ST;

void STInit(ST* ps)
{
    assert(ps != NULL);
    ps->a = NULL;
    ps->top = 0;
    ps->capacity = 0;
}

void STDestroy(ST* ps)
{
    assert(ps != NULL);
    free(ps->a);
    ps->a = NULL;
    ps->top = 0;
    ps->capacity = 0;
}

bool STEmpty(const ST* ps)
{
    return ps->top == 0;
}

int STSize(const ST* ps)
{
    return ps->top;
}

bool STPush(ST* ps, STDataType x)
{
    if (ps->top == ps->capacity)
    {
        int newcap = ps->capacity == 0 ? 4 : ps->capacity * 2;
        STDataType* tmp = (STDataType*)realloc(ps->a, sizeof(STDataType) * (size_t)newcap);
        if (tmp == NULL)
            return false;
        ps->a = tmp;
        ps->capacity = newcap;
    }

    ps->a[ps->top++] = x;
    return true;
}

bool STPop(ST* ps)
{
    if (ps->top == 0)
        return false;
    --ps->top;
    return true;
}

STDataType STTop(const ST* ps)
{
    assert(ps->top > 0);
    return ps->a[ps->top - 1];
}
STPop 只把 top 往下挪,不清理被删格子的值;下次入栈会覆盖它。STTop 用 assert 守住“栈非空”这个内部前提,参数检查应该由调用者用返回值处理,不要把用户输入直接塞进断言。扩容用 realloc,失败时原块还在,ps->a 不动;入栈返回 false,调用者可以决定重试还是放弃。
链表栈把栈顶放在链表头,头插就是入栈,头删就是出栈:
typedef struct LinkedStackNode
{
    STDataType data;
    struct LinkedStackNode* next;
} LSNode;

typedef struct LinkedStack
{
    LSNode* top;
    int size;
} LinkedStack;

void LSInit(LinkedStack* s)
{
    assert(s != NULL);
    s->top = NULL;
    s->size = 0;
}

bool LSPush(LinkedStack* s, STDataType x)
{
    LSNode* node = (LSNode*)malloc(sizeof(LSNode));
    if (node == NULL)
        return false;
    node->data = x;
    node->next = s->top;
    s->top = node;
    ++s->size;
    return true;
}

bool LSPop(LinkedStack* s)
{
    if (s->top == NULL)
        return false;
    LSNode* next = s->top->next;
    free(s->top);
    s->top = next;
    --s->size;
    return true;
}

STDataType LSTop(const LinkedStack* s)
{
    assert(s->top != NULL);
    return s->top->data;
}

bool LSEmpty(const LinkedStack* s)
{
    return s->top == NULL;
}

void LSDestroy(LinkedStack* s)
{
    while (s->top != NULL)
    {
        LSNode* next = s->top->next;
        free(s->top);
        s->top = next;
    }
    s->size = 0;
}
链表栈的入栈、出栈、取顶都是 O(1),没有扩容搬家;代价是每个元素单独 malloc 一个结点,64 位下多背一个 8 字节指针,还要付分配器的开销。数组栈和链表栈都合法,元素深度事先完全不知道、又不想预留容量时,链表栈更合适。
队列:队尾进、队头出
队列的插入端叫队尾,删除端叫队头。元素从队尾进,从队头出,先进去的先离开。
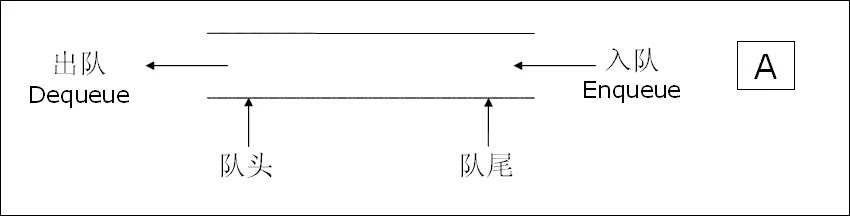
用数组实现队列,队头删除要把后面所有元素往前搬,O(N);用链表,头删只改 phead,尾插只改 ptail,两头都是 O(1)。链表队列多两个指针和一个 size,换来稳定的入队出队代价。
typedef int QDataType;

typedef struct QueueNode
{
    QDataType data;
    struct QueueNode* next;
} QNode;

typedef struct Queue
{
    QNode* phead;
    QNode* ptail;
    int size;
} Queue;

void QueueInit(Queue* pq)
{
    assert(pq != NULL);
    pq->phead = NULL;
    pq->ptail = NULL;
    pq->size = 0;
}

void QueueDestroy(Queue* pq)
{
    QNode* pcur = pq->phead;
    while (pcur != NULL)
    {
        QNode* next = pcur->next;
        free(pcur);
        pcur = next;
    }
    pq->phead = NULL;
    pq->ptail = NULL;
    pq->size = 0;
}

bool QueueEmpty(const Queue* pq)
{
    return pq->phead == NULL;
}

int QueueSize(const Queue* pq)
{
    return pq->size;
}

bool QueuePush(Queue* pq, QDataType x)
{
    QNode* newnode = (QNode*)malloc(sizeof(QNode));
    if (newnode == NULL)
        return false;
    newnode->data = x;
    newnode->next = NULL;

    if (pq->ptail == NULL)
    {
        pq->phead = newnode;
        pq->ptail = newnode;
    }
    else
    {
        pq->ptail->next = newnode;
        pq->ptail = newnode;
    }

    ++pq->size;
    return true;
}

bool QueuePop(Queue* pq)
{
    if (pq->phead == NULL)
        return false;

    QNode* next = pq->phead->next;
    free(pq->phead);
    pq->phead = next;

    if (pq->phead == NULL)
        pq->ptail = NULL;

    --pq->size;
    return true;
}

QDataType QueueFront(const Queue* pq)
{
    assert(pq->phead != NULL);
    return pq->phead->data;
}

QDataType QueueBack(const Queue* pq)
{
    assert(pq->ptail != NULL);
    return pq->ptail->data;
}
QueuePop 删到空时必须把 ptail 一起置空。只改 phead 的话,下一次 QueuePush 会走 pq->ptail->next = newnode,写进一块已经 free 掉的结点;崩溃点会出现在后面的 malloc 或别的函数里,看起来和队列无关。
size 不是摆设。判空可以直接看 phead,也可以看 size,但两个状态必须同步维护。QueuePop 只删除、不返回被删的值,想读队头要另调 QueueFront;删除和读取分开,代价是删除前必须先判空。
循环队列(circular queue):留一格换一个判据
普通数组队列还有一个假溢出:队头出队后前面的格子空着,rear 却一路往后走,走到数组末尾就再也入不了队,明明前面还有空位。把数组首尾接起来,rear 到末尾后回到 0,空间才真正循环使用。
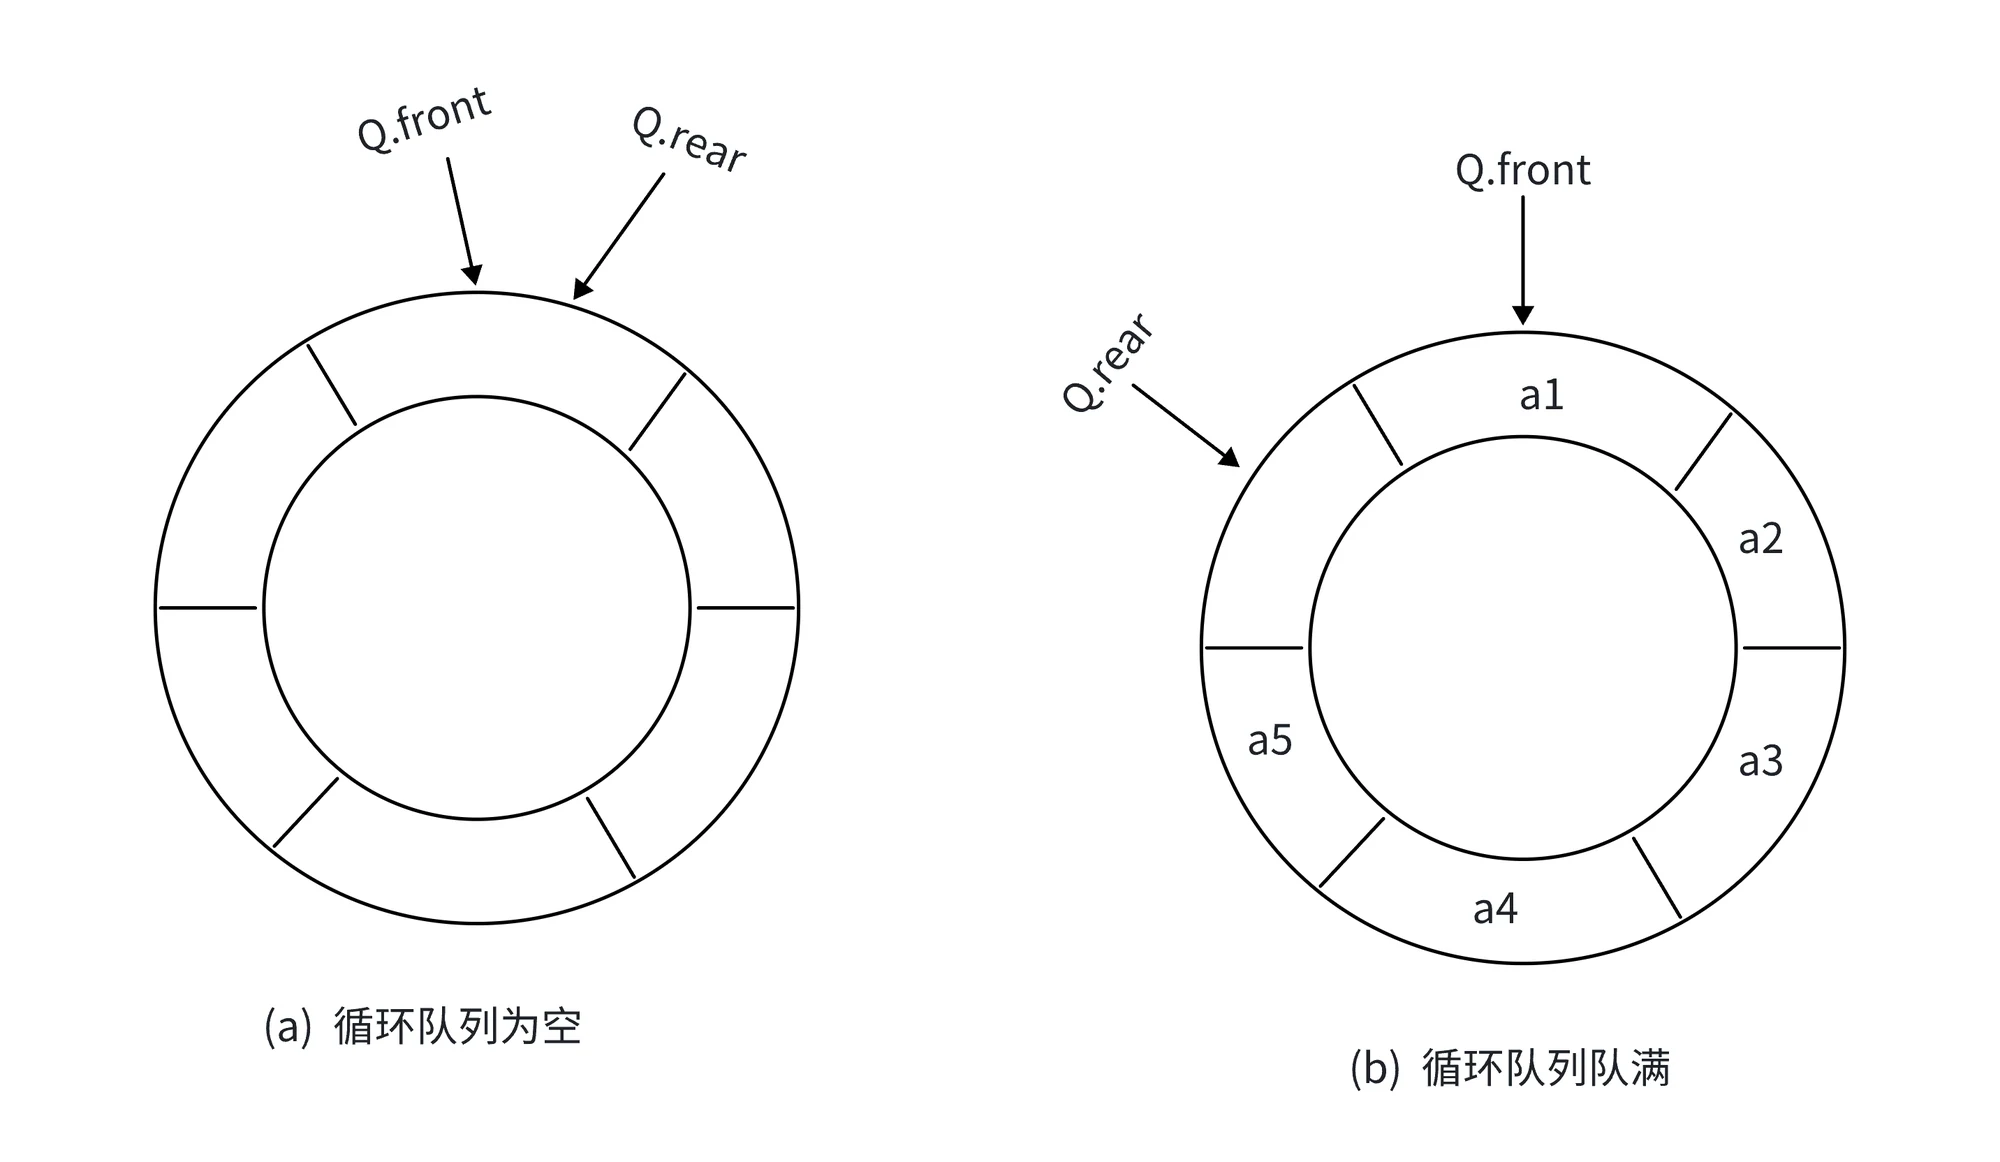
循环队列有两种常见约定:
front指队头元素,rear指下一个可写位置,数组多开一格,永远留一个空位。空:front == rear;满:(rear + 1) % len == front。front指队头元素,rear指队尾元素,两个指针都指向有效元素。这时front == rear既可能是空也可能是满,必须再存一个size或一个“上次操作是入队还是出队”的标记。
下面按第一种实现,cap 是数组长度,最多存 cap - 1 个元素:
typedef struct
{
    int* a;
    int front;      /* 队头元素下标 */
    int rear;       /* 下一个可写位置下标 */
    int cap;        /* 数组长度,实际最多存 cap - 1 个 */
} MyCircularQueue;

MyCircularQueue* MyCircularQueueCreate(int k)
{
    MyCircularQueue* q = (MyCircularQueue*)malloc(sizeof(MyCircularQueue));
    if (q == NULL)
        return NULL;

    q->a = (int*)malloc(sizeof(int) * (size_t)(k + 1));
    if (q->a == NULL)
    {
        free(q);
        return NULL;
    }

    q->front = 0;
    q->rear = 0;
    q->cap = k + 1;     /* 多开一格做空位,实际可存 k 个 */
    return q;
}

bool MyCircularQueueIsEmpty(MyCircularQueue* obj)
{
    return obj->front == obj->rear;
}

bool MyCircularQueueIsFull(MyCircularQueue* obj)
{
    return (obj->rear + 1) % obj->cap == obj->front;
}

int MyCircularQueueSize(MyCircularQueue* obj)
{
    return (obj->rear - obj->front + obj->cap) % obj->cap;
}

bool MyCircularQueueEnQueue(MyCircularQueue* obj, int value)
{
    if (MyCircularQueueIsFull(obj))
        return false;

    obj->a[obj->rear] = value;
    obj->rear = (obj->rear + 1) % obj->cap;
    return true;
}

bool MyCircularQueueDeQueue(MyCircularQueue* obj)
{
    if (MyCircularQueueIsEmpty(obj))
        return false;

    obj->front = (obj->front + 1) % obj->cap;
    return true;
}

int MyCircularQueueFront(MyCircularQueue* obj)
{
    if (MyCircularQueueIsEmpty(obj))
        return -1;
    return obj->a[obj->front];
}

int MyCircularQueueRear(MyCircularQueue* obj)
{
    if (MyCircularQueueIsEmpty(obj))
        return -1;
    return obj->a[(obj->rear - 1 + obj->cap) % obj->cap];
}

void MyCircularQueueFree(MyCircularQueue* obj)
{
    free(obj->a);
    free(obj);
}
rear 指向的格子永远空着,这是“留一格”的全部含义。课件问“队列满的情况下,为什么 Q.rear 不存储数据”,答案是:要让队满条件 (rear + 1) % cap == front 和队空条件 front == rear 区分开。课件把判满写成 rear + 1 = front,漏了取模;rear 没绕回时两者等价,一旦 rear 走到数组末尾、下一格是下标 0,rear + 1 等于 cap,而 front 可能是 0,等式不成立,队满判不出来,接着就是覆盖还没读的数据。
课件还有一句“为了能使用 rear = front 来区别队空还是队满”,这句话自相矛盾。如果允许 rear 指向的格子存数据,队满时 rear 确实会和 front 重合,可那时两个指针相等,既表示空又表示满,根本区分不了。真正的办法是结构性的:要么留一格,要么多存一个 size,不能只靠两个指针相等。
MyCircularQueueSize 里的 + obj->cap 不是防御性写法,是必须的。C 的除法向零截断,余数的符号跟着被除数走;rear 小于 front 时,(rear - front) % cap 是负数,直接拿去当长度会得到负值。先加一个 cap,结果才落回 [0, cap)。
两个结构互相实现
有效括号是栈的最小应用:遇到左括号压栈,遇到右括号就和栈顶比,比完弹出;扫描结束时栈必须为空。
#include <string.h>

bool IsValid(char* s)
{
    int n = (int)strlen(s);
    char* st = (char*)malloc(sizeof(char) * (size_t)(n == 0 ? 1 : n));
    if (st == NULL)
        return false;

    int top = 0;
    bool ok = true;

    for (int i = 0; i < n && ok; ++i)
    {
        char c = s[i];
        if (c == '(' || c == '[' || c == '{')
        {
            st[top++] = c;
        }
        else if (c == ')' || c == ']' || c == '}')
        {
            if (top == 0)
            {
                ok = false;
            }
            else
            {
                char t = st[--top];
                if ((c == ')' && t != '(') ||
                    (c == ']' && t != '[') ||
                    (c == '}' && t != '{'))
                    ok = false;
            }
        }
    }

    if (top != 0)
        ok = false;

    free(st);
    return ok;
}
栈里存的是“还没配对的左括号”。右括号多出来时,栈已经空了却还要弹;左括号多出来时,扫描结束栈里还有剩。两种错误都在栈的状态上现形。
用两个栈实现队列:in 负责入队,out 负责出队;out 空的时候,把 in 里的元素全部倒过去。
typedef struct
{
    ST in;
    ST out;
} MyQueue;

MyQueue* MyQueueCreate(void)
{
    MyQueue* q = (MyQueue*)malloc(sizeof(MyQueue));
    if (q == NULL)
        return NULL;
    STInit(&q->in);
    STInit(&q->out);
    return q;
}

void MyQueuePush(MyQueue* obj, int x)
{
    STPush(&obj->in, x);
}

static void MoveInToOut(MyQueue* obj)
{
    if (STEmpty(&obj->out))
    {
        while (!STEmpty(&obj->in))
        {
            STPush(&obj->out, STTop(&obj->in));
            STPop(&obj->in);
        }
    }
}

int MyQueuePop(MyQueue* obj)
{
    MoveInToOut(obj);
    int x = STTop(&obj->out);
    STPop(&obj->out);
    return x;
}

int MyQueuePeek(MyQueue* obj)
{
    MoveInToOut(obj);
    return STTop(&obj->out);
}

bool MyQueueEmpty(MyQueue* obj)
{
    return STEmpty(&obj->in) && STEmpty(&obj->out);
}

void MyQueueFree(MyQueue* obj)
{
    STDestroy(&obj->in);
    STDestroy(&obj->out);
    free(obj);
}
每个元素一辈子最多从 in 搬到 out 一次,总代价线性,均摊 O(1),单次最坏 O(N)。out 里还有元素时不倒,是因为倒过去会把队头压到栈底,顺序就反了。
用两个队列实现栈:入栈时把元素放进非空的那个队列;出栈时把非空队列的前 size - 1 个元素搬到另一个队列,剩下的最后一个就是栈顶。
typedef struct
{
    Queue q1;
    Queue q2;
} MyStack;

MyStack* MyStackCreate(void)
{
    MyStack* s = (MyStack*)malloc(sizeof(MyStack));
    if (s == NULL)
        return NULL;
    QueueInit(&s->q1);
    QueueInit(&s->q2);
    return s;
}

void MyStackPush(MyStack* obj, int x)
{
    Queue* nonempty = QueueEmpty(&obj->q1) ? &obj->q2 : &obj->q1;
    QueuePush(nonempty, x);
}

int MyStackPop(MyStack* obj)
{
    Queue* from = QueueEmpty(&obj->q1) ? &obj->q2 : &obj->q1;
    Queue* to = (from == &obj->q1) ? &obj->q2 : &obj->q1;

    while (QueueSize(from) > 1)
    {
        QueuePush(to, QueueFront(from));
        QueuePop(from);
    }

    int x = QueueFront(from);
    QueuePop(from);
    return x;
}

int MyStackTop(MyStack* obj)
{
    Queue* from = QueueEmpty(&obj->q1) ? &obj->q2 : &obj->q1;
    Queue* to = (from == &obj->q1) ? &obj->q2 : &obj->q1;

    while (QueueSize(from) > 1)
    {
        QueuePush(to, QueueFront(from));
        QueuePop(from);
    }

    int x = QueueFront(from);
    QueuePush(to, x);
    QueuePop(from);
    return x;
}

bool MyStackEmpty(MyStack* obj)
{
    return QueueEmpty(&obj->q1) && QueueEmpty(&obj->q2);
}

void MyStackFree(MyStack* obj)
{
    QueueDestroy(&obj->q1);
    QueueDestroy(&obj->q2);
    free(obj);
}
MyStackTop 把最后一个元素也搬到另一个队列,读完再搬回去,这样队列的尾部仍是栈顶,下一次 Pop 不用重新找方向。两个队列实现的入栈是 O(1),出栈和取顶是 O(N);两个栈实现的入队是 O(1),出队均摊 O(1)。结构互相模拟时,代价总会落在某一个操作上,没有免费的对称。
栈和队列在别处也常见:层序遍历二叉树、图的 BFS 用队列,“发现一个邻居就入队,处理完一个结点就出队”;表达式求值、括号匹配、撤销操作和 DFS 用栈。它们不是两种容器名字,而是两种“下一步处理谁”的规则。
还没有评论 — 第一条由你来留。