以太网帧有一个固定模板:目的 MAC 6 字节,源 MAC 6 字节,类型 2 字节,数据 46~1500 字节,FCS 4 字节。模板前面还有 8 字节前导码,负责把接收方的采样时钟和发送方对上;模板后面还有 12 字节帧间隙,让相邻两帧不至于连成一片。这两个东西都不计入帧长,所以抓包工具报的长度通常比线上实际传的短:它既不含前导码,也不含帧间隙,有的驱动连 FCS 都不交给上层。
链路层只管一跳,网络层管全程
数据链路层负责相邻两个节点之间把数据递过去,网络层负责在整张网络里选一条路。课件用唐僧和白龙马做对照:IP 地址是长安到灵山的全程终点,MAC 地址是每一段路的起点和终点。
这个分法能一直用下去。一个包从出发到落地,目的 IP 一个字节都不变;源 MAC 和目的 MAC 则每过一台路由器就整套换新,换成"这一跳谁发、这一跳谁收"。所以链路层回答的是"这一帧交给谁",不是"这个包最终去哪"。
14 字节帧头,前导码不算在帧里
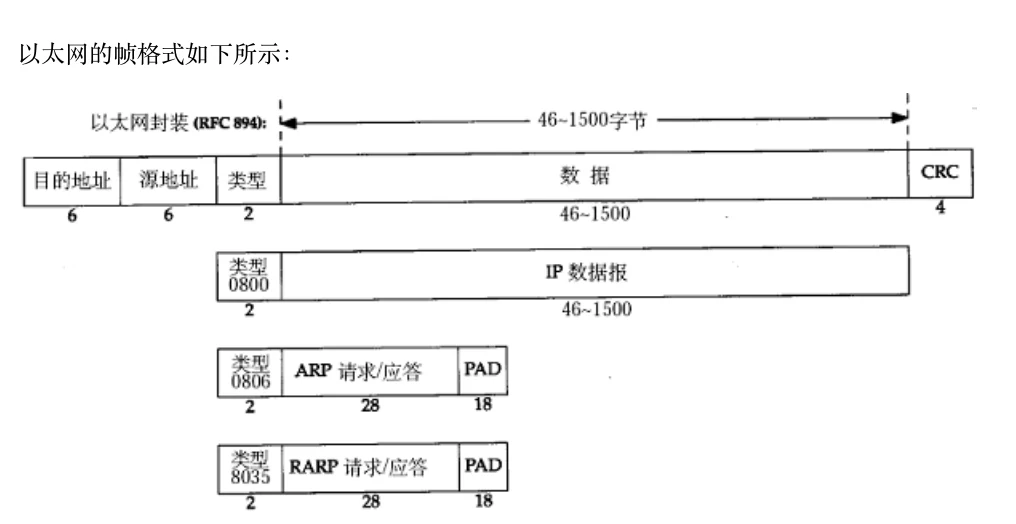
帧头是 6 + 6 + 2。目的地址占前 6 字节,全 FF 表示广播;源地址占中间 6 字节;最后 2 字节在 Ethernet II 里是类型,0x0800 是 IPv4,0x0806 是 ARP,0x8035 是 RARP。课件列的这三种值就是这一讲会用到的全部。
这个字段在 IEEE 802.3 里还承担另一个角色:数据长度。区分办法看数值,大于等于 0x0600(1536)按类型解释,小于等于 1500 按长度解释。以太网数据区最长 1500,所以长度字段不可能超过 1500,两种解释刚好不重叠。
前导码是 7 字节的 10101010,后面跟 1 字节帧首定界符 10101011。它只做一件事:让对方的接收电路在真正的帧头到来之前锁定比特边界。前导码不参与校验,也不写入任何长度字段。
46 与 64:最小长度是碰撞检测留下的
数据区下限 46 字节。这个下限不是为了兼容谁,而是为了在老式共享以太网上还能检测到碰撞。
10Mbit/s 的同轴电缆上,最远两台机器的往返传播时间约 51.2 微秒,折算成比特是 512 位,也就是 64 字节。发送方要能"边发边听",就必须在自己发完之前收到碰撞信号,否则它会误以为发送成功。于是整帧不得短于 64 字节,而帧头和帧尾已经占了 14 + 4 = 18 字节,留给数据区的最小值就是 46。
一个 ARP 报文只有 28 字节,差 18,必须在后面补零凑够 46。补完之后整帧 14 + 46 + 4 = 64 字节。现代交换机全双工工作,碰撞几乎不会发生,这条规定依然保留,所以 ARP 帧照样要补。
帧尾的 FCS 是 4 字节 CRC-32,生成多项式 0x04C11DB7,覆盖范围从目的地址一直到数据区(含填充)结束,不含前导码和帧首定界符。它只能发现错误,不能纠正;校验失败整帧丢弃,重发由上层负责。
因此一帧的合法长度是 64~1518 字节(不含前导码和帧间隙)。1500 是数据区上限,1518 是整帧上限,等于 14 + 1500 + 4。插了 4 字节 VLAN 标签的帧上限变成 1522。抓包看到 length 42 说的是 14 + 28,看到 length 1500 说的是数据区,这几个数不能混着用。
MAC 地址描述的是每一跳
MAC 地址 48 位,也就是 6 字节,通常写成 08:00:27:03:fb:19 这样的六组十六进制。前 3 字节是 IEEE 分配给厂商的 OUI;第一字节的最低位是单播/组播标志,广播地址 FF:FF:FF:FF:FF:FF 六字节全 1,所有网卡都会收下。
课件说 MAC 地址"在网卡出厂时就确定了,不能修改"。前半句对,后半句要打折。地址确实烧在网卡的 EEPROM 里,但驱动可以把网卡寄存器里的过滤地址改掉,Linux 上用 ip link set dev eth0 address 08:00:27:03:fb:1a 就能换,Windows 的设备管理器里也有类似选项。虚拟机的 MAC 更是由软件生成,同一个网段里出现两块相同 MAC 并不罕见。这说明"靠 MAC 唯一性做身份认证"在安全上不成立,MAC 只能当作链路内的寻址标签。
MTU 1500,超出的部分交给 IP 分片
MTU(Maximum Transmission Unit)是链路层一次能承载的最大 IP 数据量,以太网是 1500。这个值由具体链路决定:FDDI 是 4352,PPPoE 因为多了 8 字节头部降成 1492,回环接口可以到 65536。
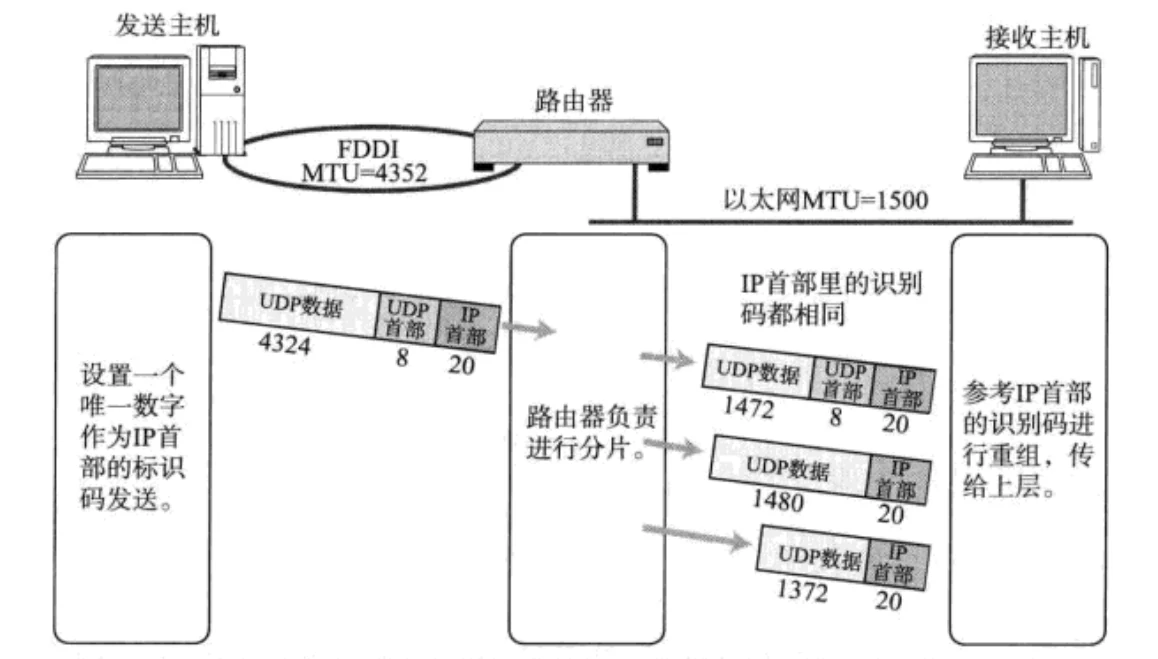
IP 层的处理办法是分片。IPv4 头里有三个字段配合:16 位标识(id)标识"这些片属于同一个数据报",3 位标志里 DF 表示禁止分片、MF 表示后面还有片,13 位片偏移以 8 字节为单位记录这一片在原数据报中的位置。
课件这里把标志位的含义写反了,原话是"第 3 位来表示结束标记(当前是否是最后一个小包,是的话置为 1,否则置为 0)"。按 RFC 791,MF 置 1 表示"后面还有分片",最后一片才置 0。若照课件反过来填,接收端永远等不到结束标记,重组无法完成。同一段里"第 2 位置为 0 表示允许分片"是对的:第 2 位是 DF,DF = 0 才允许分片。
分片在目的端重组,任何一片丢失都会导致整个数据报作废。IP 层不负责重传,重传是 TCP 的事;UDP 没有重传,所以分片对 UDP 是纯损失。
1472 和 1460 都是从 1500 里减出来的
MTU 限制的是"IP 头 + 传输层头 + 数据"。往下减一层,能装的应用数据就少一截:
以太网 MTU                     1500
  − IPv4 头 20 字节     →       1480
  − UDP 头 8  字节      →       1472
  − TCP 头 20 字节      →       1460
UDP 应用一次写超过 1472 字节,网络层就会分片;只要有一片丢失,整个数据报被丢弃,UDP 不会重传。这就是大 UDP 报文在网络里特别脆弱的原因。
TCP 用 MSS(Maximum Segment Size)主动绕开分片。建连时双方在 SYN 的选项里各自报一个 MSS,取两者较小的作为发送上限。这里的 MSS 指的是 TCP 数据部分的最大长度,不含 TCP 头,也不含 IP 头。
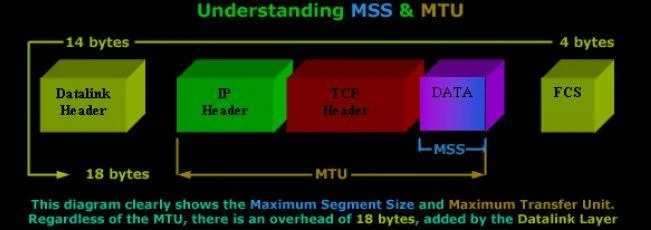
课件说"MSS 的值就是在 TCP 首部的 40 字节变长选项中(kind=2)",这句话把两个数揉在一起了。MSS 选项本身只占 4 字节:1 字节 kind(值为 2)、1 字节 length(值为 4)、2 字节数值。40 字节是 TCP 选项区的总长度上限(TCP 头最长 60 字节,固定部分 20 字节),不是这个选项的长度。另外"最理想情况下 MSS 正好是 IP 不会被分片的最大长度"也不太准:MSS 加上 20 字节 IP 头和 20 字节 TCP 头(都不含选项),才等于不分片时 IP 数据报的最大长度。MSS 描述的是载荷,不是整个数据报,两者差着两个头共 40 字节。
1460 是 TCP 头不带选项时的经典值。启用时间戳、窗口缩放这些选项后 TCP 头会变长,MSS 相应缩小。想知道路径上实际能过多大的包,可以用带禁止分片的 ping:
$ ping -c 1 -M do -s 1472 192.168.1.1
1480 bytes from 192.168.1.1: icmp_seq=1 ttl=64 time=1.10 ms

$ ping -c 1 -M do -s 1473 192.168.1.1
ping: local error: message too long, mtu=1500
-s 是 ICMP 数据长度,加上 8 字节 ICMP 头和 20 字节 IP 头正好 1500;多发 1 字节,内核在本地就拒绝发送。
ARP 把下一跳的 IP 翻译成 MAC
链路层只认 MAC,路由决策只认 IP,两者之间需要一个翻译。ARP 干这件事,它夹在链路层和网络层之间,既不属于纯粹的链路层协议,也不属于网络层协议。
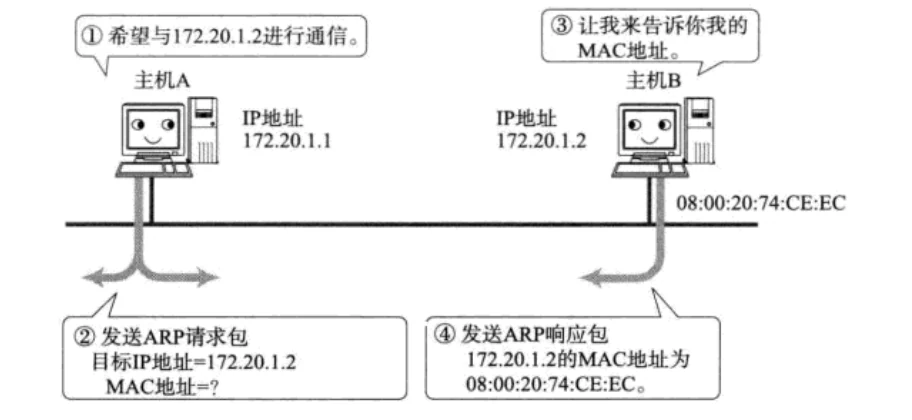
流程很短:源主机在广播域里发一条请求,以太网帧目的地址填 FF:FF:FF:FF:FF:FF;所有主机都收到,只有目标 IP 匹配的那一台应答;应答改成单播,目的地址就是提问者的 MAC。两边顺手把对方的映射写进缓存,下次直接查表,不用再广播。
之所以必须先解析:网卡收到帧,第一件事是比对目的 MAC。不是自己、不是广播、不是组播,就直接丢弃,IP 地址在这一层没有任何意义。映射存进 ARP 缓存后还会老化,换网卡、改 IP 之后旧记录会被淘汰,不至于一直指错地方。
交换机按 MAC 转发,集线器只复制电平
以太网之所以叫"技术标准"而不是"一种网络",是因为它同时规定了链路层和部分物理层的内容:拓扑、访问控制方式、传输速率。双绞线、10M/100M/1000M 这些都在标准里。和以太网并列的还有令牌环网、无线局域网。
同样是把几台机器接在一起,集线器和交换机差一整层:
- 集线器(hub)工作在物理层,一个端口收到的电平会复制到所有其他端口。所有端口共享一个冲突域和一份带宽,只能半双工,碰撞靠 CSMA/CD 退避重发。
- 交换机工作在数据链路层,每个端口是独立的冲突域,可以全双工。它记录"源 MAC 从哪个端口进来",据此建立 MAC 地址表;收到帧先查目的 MAC,查到就只从对应端口发出,查不到就向除来源端口外的所有端口泛洪。
交换机不隔离广播域。目的 MAC 全 FF 的帧照样泛洪到所有端口,一台交换机下的设备共享同一个广播域。切开广播域要靠路由器,或者交换机上的 VLAN。VLAN 的做法是在源 MAC 和类型字段之间插 4 字节标签,其中 12 位是 VLAN ID,这也是带标签的帧上限变成 1522 的原因。
看硬件地址和 MTU
课件用 ifconfig 查看 IP、MAC 和 MTU:
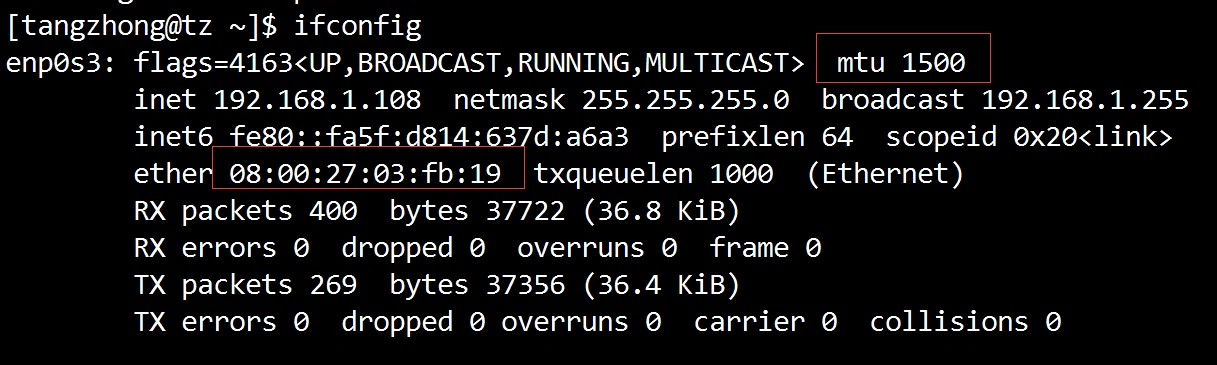
ifconfig 属于 net-tools,早已停止维护,不少新发行版默认不装。等价的写法是:
$ ip link show eth0
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP
    link/ether 08:00:27:03:fb:19 brd ff:ff:ff:ff:ff:ff
mtu 和 link/ether 都在第一行和第二行里,ip -s link show eth0 还能顺带给出收发计数和错误数。
这一层要记的边界只有三个:46 决定补多少,1500 决定能装多少,64 决定最短多少。IP 分片、UDP 的 1472、TCP 的 1460,都是这三条推出来的后果。
还没有评论 — 第一条由你来留。