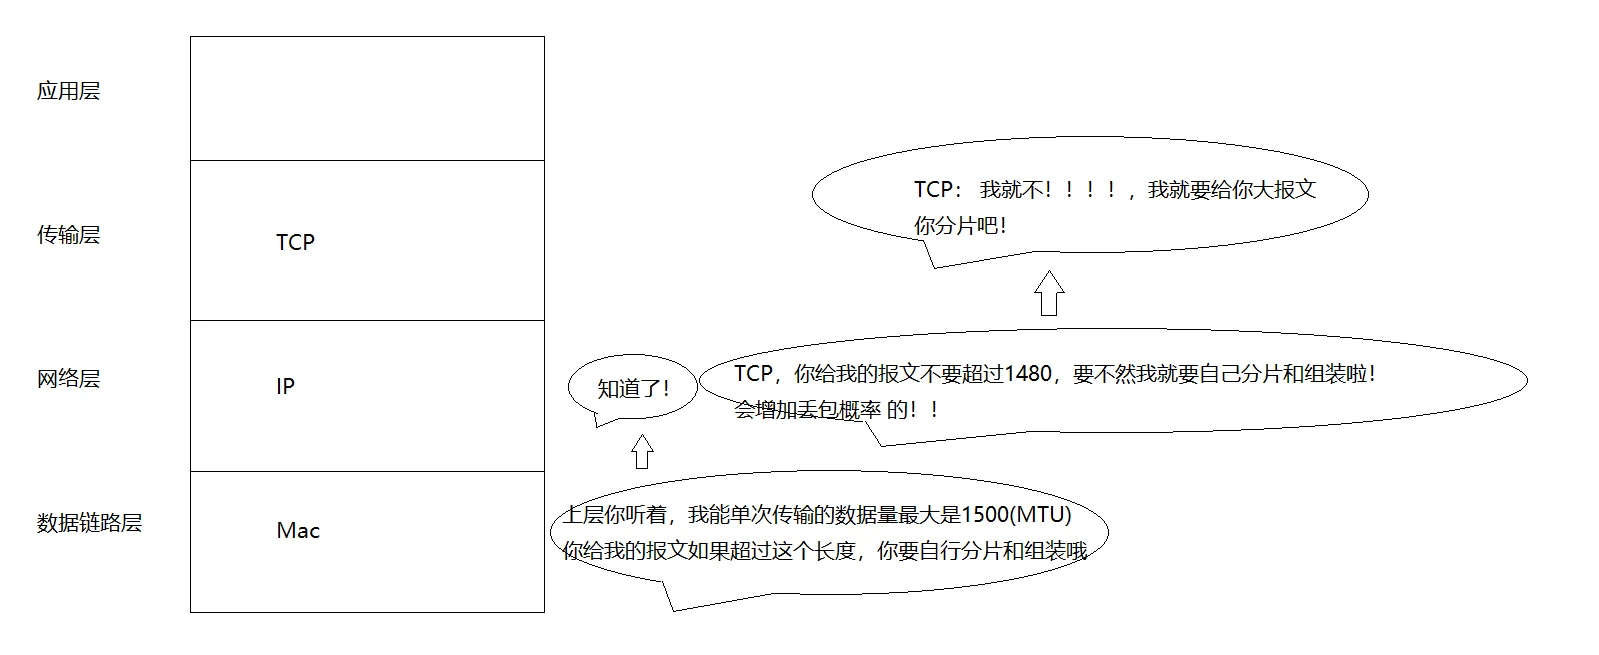
MTU(Maximum Transmission Unit,最大传输单元)是链路层一次能封进帧里的最大长度,以太网是 1500 字节。IP 报文的总长度(含首部)超过它时,网络层只有两条路:切片,或者设置 DF 位后丢弃并回 ICMP 让源端自己调小。默认是切片。
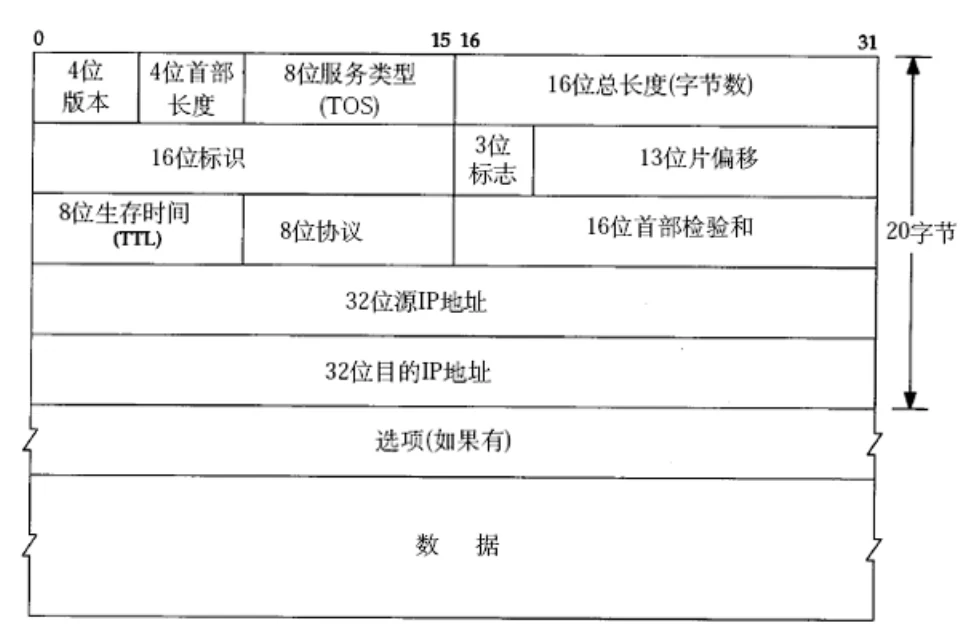
分片三件套:标识、标志、片偏移
16 位标识(Identification):同一原始报文的所有分片共用同一个值。接收端靠它把片归到一组。它不是全局唯一,会回绕,只在一个(源 IP,目的 IP,协议号)的组合内有意义。
3 位标志:第一位保留;第二位 DF(Don't Fragment),置 1 表示禁止分片,超过 MTU 就丢弃并回 ICMP;第三位 MF(More Fragments),除最后一片外都置 1,等于“后面还有”。
13 位片偏移(Fragment Offset):本片数据在原始报文数据区里的位置,以 8 字节为单位。RFC 791 的原话是 measured in units of 8 octets,字段值乘 8 才是字节偏移。课件写“实际偏移的字节数是这个值除以 8 得到的”,方向反了;3000 字节例子里第二片从第 1480 字节开始,字段填 185,因为 1480 ÷ 8 = 185,反推则是 185 × 8 = 1480。
为什么用 8 字节做单位?13 位最大表示 8191,乘 8 是 65528,刚好卡在 IPv4 报文上限 65535 以下。改成 4 字节单位只能覆盖 32764,不够;改成 16 字节又浪费精度,还强制每片长度是 16 的倍数。8 是刚好够用的值。
这个单位带来一条约束:除最后一片外,每一片的长度必须是 8 的倍数。不是因为标准偏心,而是下一片的起始位置要写进这个字段,起点不对齐 8 就表达不出来。最后一片是尾巴,后面没有片要接,20 字节也可以。
3000 字节的报文切成三片
假设原始 IP 报文 3000 字节,首部 20 字节,数据 2980 字节,路径 MTU 是 1500。每片最多带 1500 字节,其中 20 字节要留给自己的首部,所以每片数据最多 1480 字节:
片 1:数据 [0, 1479]      1480 字节   偏移 0     MF=1   总长度 1500
片 2:数据 [1480, 2959]   1480 字节   偏移 185   MF=1   总长度 1500
片 3:数据 [2960, 2979]     20 字节   偏移 370   MF=0   总长度 40
算一遍:1480 + 1480 + 20 = 2980;185 × 8 = 1480;370 × 8 = 2960。三片的标识相同,源地址、目的地址、协议号、TTL 全部照抄,只改总长度、MF、片偏移,并重算首部校验和。每片独立选择路由,可能走不同路径、以不同顺序到达。
每片都要自带一个 20 字节首部,这就是分片的固定开销。三片多发两个头,40 字节;报文越大,片越多,开销按比例增加。一个 60 KB 的报文能被切成四十多片,额外开销近千字节。
重组:按偏移落位,不需要先排序
接收端收到分片后,用四元组(标识、源地址、目的地址、协议号)判断它们是不是同一次分片出来的,相同的放进同一个重组缓冲区。
判断收全了没有,要三条同时成立:
- 收到了偏移 0 的首片。
- 收到了 MF=0 的尾片。
- 缓冲区
[0, 总长)里没有空洞。
只凭尾片能算出总长:尾片偏移 × 8 + 尾片数据长度;但算出总长不等于收齐。只拿到偏移 0 和偏移 370 的两片,长度算得出来,中间 185 那一片没来,交上去就是一段被截掉的数据。
重组动作是按偏移把数据直接写进缓冲区的对应位置,跟到达顺序无关。课件说“利用片偏移对分片进行排序,当所有分片到达并正确排序后再组装”,前半句想多了:乱序来的片照样能拼对,不需要先排一遍队。
Linux 给每个重组队列配了超时(net.ipv4.ipfrag_time,默认 30 秒),时间到还没齐就整组丢弃。
这三个问题到这里有答案了:
- 接收方怎么知道报文被分片了?看 MF 是否为 1,或片偏移是否为 0 以外。
- 怎么知道收全了?首片、尾片都在,且中间没有空洞。
- 怎么组合?按四元组归组,按偏移 × 8 落位。
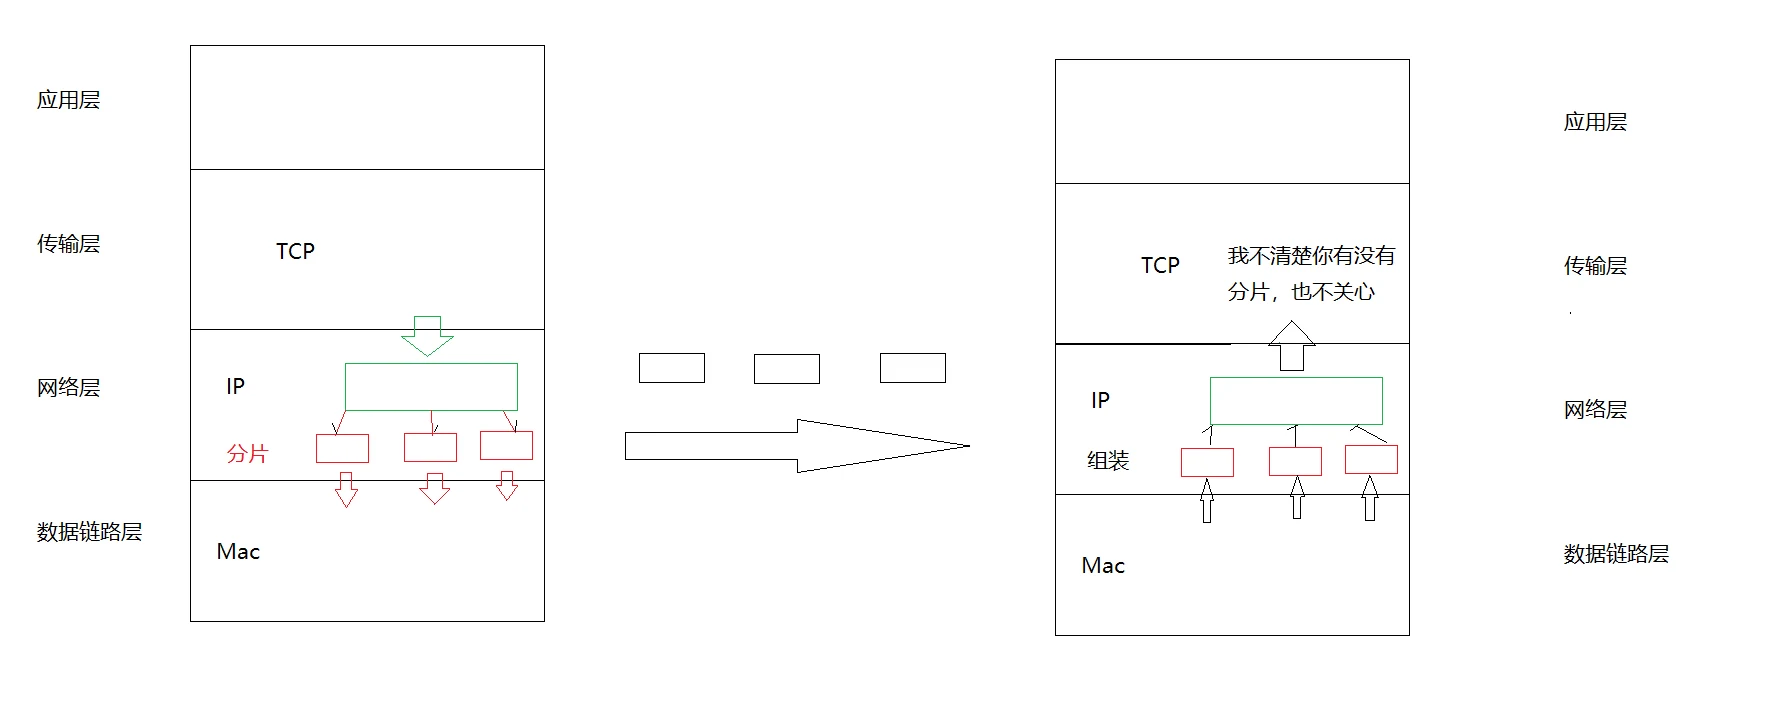
分片对传输层是透明的。TCP 和 UDP 都不知道 IP 层切过报文,重组由目的主机的 IP 层完成。
路由器不顺手重组,原因很实在:所有经过的流量都得缓存,内存扛不住;不同片可能走不同下一跳,在一个路由器上未必凑得齐;重组缓冲区还是拒绝服务的经典靶子。IPv4 只在最终目的地重组;IPv6 走得更远,RFC 8200 规定分片只能由源节点做,沿途路由器连切都不许切。
分片能工作,但不该被依赖
分片的代价不止那几十字节首部:
- 丢片放大。一片丢了,整组都拼不齐,接收端把整个报文丢掉。TCP 会重传,最坏卡一下;UDP 没有重传,一次 60 KB 的数据被切成四十来片,丢任何一片,应用只看到“没收到”。
- 重组缓冲被占满。大量半成品分片堆在内核里,达到
ipfrag_high_thresh后新分片被丢,正常流量跟着受影响。 - 标识回绕与碰撞。16 位标识会绕回,理论上两台机器在同一时段用同一个标识、发往同一个目的地、同一个协议,就可能被串到一起。
- 二次分片。路径上某段 MTU 更小(比如 1300 的隧道),已经切过的片还会再被切一次;偏移必须基于原始数据区重新算,不能基于中间片。
避开分片的办法有两层。传输层先协商 MSS:TCP 握手时把 MTU − 20(IP) − 20(TCP) = 1460 告诉对方,让对方一开始就别发大包;IPv6 下是 MTU − 40 − 20 = 1440。UDP 没有这个机制,只能在应用层自己限制报文长度,常见做法是压到 1472 以下(1500 减 20 字节 IP 首部、8 字节 UDP 首部)。
再配路径 MTU 发现(PMTUD):发出的包一律标 DF,谁过不去谁就回 ICMP“需要分片但设了 DF”,并带上下一跳的 MTU,发送端据此调小。麻烦在于现实里很多防火墙把 ICMP 全过滤了,消息到不了源端,探测永远停不下来,表现就是小包通、大包卡死。
# 1472 + 8(ICMP) + 20(IP) = 1500,刚好压线
ping -M do -s 1472 192.168.1.10
# 1473 超过 MTU,本机直接报 message too long,一个包都不发
ping -M do -s 1473 192.168.1.10
第二条失败在本地,跟网络无关。真正有诊断价值的是链路另一端 ping 回来的结果:小包通、大包不通,问题就锁定在 MTU 或 ICMP 过滤上,而不是丢包率或带宽。
分片是 IPv4 的兜底能力,不是常规传输方式。能靠 MSS 协商和应用层分块解决,就不要把重组的锅丢给中间的路由器。
还没有评论 — 第一条由你来留。